导图社区 数据集
这是一个关于数据集的思维导图,讲述了数据集的相关故事,如果你对数据集的故事感兴趣,欢迎对该思维导图收藏和点赞~
提示: 本内容由社区用户上传并分享。平台不对内容的真实性、合法性、知识产权归属及是否侵害第三方权利进行事前审核或保证。本内容可能包含受版权保护的图片、字体或其他第三方素材,使用前请自行确认授权范围。
这是一个关于数据治理平台 大数据中心的思维导图,讲述了数据治理平台 大数据中心的相关故事,如果你对数据治理平台 大数据中心的故事感兴趣,欢迎对该思维导图收藏和点赞~
这是一个关于数据分析目标的步骤有哪些的思维导图,讲述了数据分析目标的步骤有哪些的相关故事,如果你对数据分析目标的步骤有哪些的故事感兴趣,欢迎对该思维导图收藏和点赞~
这是一个关于数据与信息的区别和联系的思维导图,讲述了数据与信息的区别和联系的相关故事,如果你对数据与信息的区别和联系的故事感兴趣,欢迎对该思维导图收藏和点赞~
社区模板帮助中心,点此进入>>
Human3.6M
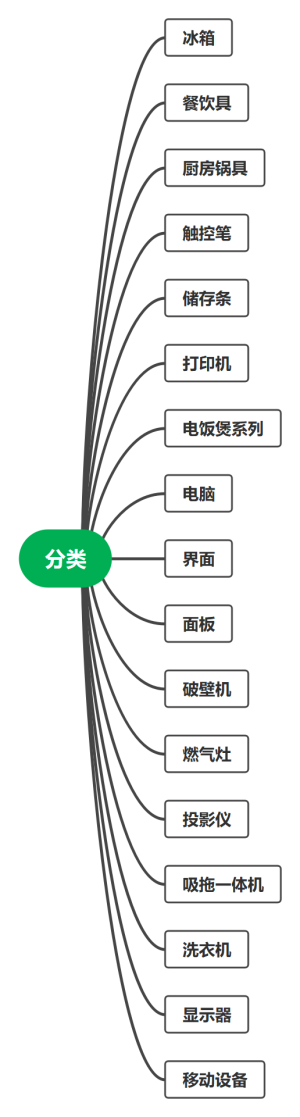
数据集构建分类
数据集
概述
数据集是指在统计学和机器学习中用来研究和训练模型的数据的集合。
数据集包含了多个样本或观测点,每个样本都有多个特征或属性。
数据集的质量和规模对于模型的性能和准确性至关重要。
数据集类型
结构化数据集
结构化数据集是由表格、关系型数据库或电子表格等形式表示的数据。
每个数据项都有明确定义的数据类型和顺序。
结构化数据集具有易于抽取、处理和分析的优势。
非结构化数据集
非结构化数据集指的是没有固定格式或组织形式的数据。
非结构化数据集包括文本、图像、音频和视频等。
处理非结构化数据集需要使用特定的技术和工具。
半结构化数据集
半结构化数据集介于结构化和非结构化数据集之间。
半结构化数据集包含一些组织或格式信息,但不如结构化数据集那么规范。
XML和JSON是常见的半结构化数据集表示格式。
数据集收集
数据采集
数据采集是从各种来源收集数据的过程。
可以通过调查问卷、传感器、Web爬虫等方式获取数据。
数据采集需要考虑数据安全和隐私保护的问题。
数据清洗
数据清洗是对收集到的数据进行预处理和修复的过程。
清洗数据可以包括去除重复项、处理缺失值和异常值等。
数据清洗能够提高数据质量和准确性。
数据标注
数据标注是为数据集中的每个样本添加标签或注释的过程。
标注可以是分类、回归、目标检测等不同类型。
数据标注的质量对于机器学习模型的训练和评估至关重要。
数据集划分
训练集
训练集是用于训练机器学习模型的数据子集。
训练集通常占总数据集的70%到80%。
训练集的选择要能够代表整个数据集的分布和特征。
验证集
验证集是用于调整模型参数和进行模型选择的数据子集。
验证集通常占总数据集的10%到20%。
验证集的使用可以帮助评估模型的性能和避免过拟合。
测试集
测试集是用于评估模型性能和泛化能力的数据子集。
测试集通常占总数据集的10%到20%。
测试集的选择要与训练集和验证集独立并具有代表性。
数据集应用
机器学习
数据集是机器学习中训练和评估模型的基础。
机器学习算法可以通过数据集识别和学习出模式。
数据集的质量和规模直接影响机器学习模型的性能。
数据分析
数据集可以用于分析和发现数据中的趋势和关联。
数据分析可以帮助做出合理的决策和预测。
数据集的可视化和摘要统计分析是常见的数据分析方法。
数据挖掘
数据集是数据挖掘中挖掘模式和关联规则的基础。
数据挖掘可以识别出隐藏在数据背后的规律和知识。
数据集的选择和处理对于数据挖掘结果的可靠性和有效性至关重要。