导图社区 编译原理
- 103
- 2
- 1
- 举报
编译原理
大学编译原理课程一张图掌握,过去大部分深度生成模型的研究集中在提供概率分布函数参数化的模型上。提出了一种生成机制,不需要显式表示概率似然,但能够从所需分布中生成样本。
提示: 本内容由社区用户上传并分享。平台不对内容的真实性、合法性、知识产权归属及是否侵害第三方权利进行事前审核或保证。本内容可能包含受版权保护的图片、字体或其他第三方素材,使用前请自行确认授权范围。
- 编译原理
- 计算机专业
- 相似推荐
- 大纲
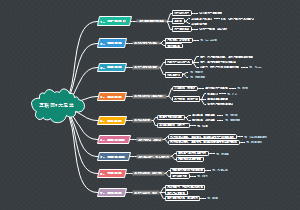


课程内容集
苍神学习术
关键词工程
1. 编译器(Compiler):将源代码转换为目标代码的软件工具。
2. 解释器(Interpreter):逐行执行源代码并直接生成结果的软件工具。
3. 词法分析器(Lexer):将源代码转换为词法单元的组合,如标识符、关键字、运算符等。
4. 语法分析器(Parser):根据语法规则分析词法单元的组合,并生成语法树。
5. 语法树(Parse Tree):以层次结构表示源代码的语法结构。
6. 语义分析(Semantic Analysis):对语法树进行类型检查和语义验证的过程。
7. 中间代码(Intermediate Code):在源代码和目标代码之间表示的中间形式。
8. 优化(Optimization):改进中间代码以提高目标代码的性能和效率。
9. 目标代码生成(Code Generation):将中间代码转换为特定硬件或操作系统的机器代码。
10. 符号表(Symbol Table):保存程序中的标识符和相关信息的数据结构。
11. 上下文无关文法(Context-Free Grammar):描述编程语言语法规则的形式化语言。
12. LL语法分析(LL Parsing):从左到右扫描源代码,使用左推导的语法分析方法。
13. LR语法分析(LR Parsing):从左到右扫描源代码,使用右推导的语法分析方法。
14. 递归下降分析(Recursive Descent Parsing):使用递归函数实现的一种语法分析方法。
15. 语法制导翻译(Syntax-Directed Translation):在语法分析的同时进行语义动作。
16. 属性文法(Attribute Grammar):在语法规则中添加属性以描述语义动作。
17. 语义动作(Semantic Action):在语法分析中执行的与语义相关的操作。
18. 语义规则(Semantic Rule):描述语义动作和语义约束的规则。
19. 数据流分析(Data Flow Analysis):通过静态分析确定程序中数据的传递和使用情况。
20. 活跃变量分析(Liveness Analysis):分析程序中变量的生命周期和使用情况。
21. 常量折叠(Constant Folding):在编译时计算和替换可以确定的常量表达式。
22. 寄存器分配(Register Allocation):将变量映射到处理器寄存器的过程。
23. 代码优化技术(Code Optimization Techniques):
提高目标代码质量和性能的技术。
24. 数据依赖分析(Data Dependency Analysis):确定指令之间的数据依赖关系。
25. 内联展开(Loop Unrolling):将循环展开为等效但更长的代码段。
26. 数据流图(Data Flow Graph):表示程序中数据流和控制流的有向图。
27. 代码生成器(Code Generator):将中间代码转换为目标代码的模块。
28. 优化编译器(Optimizing Compiler):在编译过程中应用多种优化技术的编译器。
29. 词法分析器生成器(Lexer Generator):自动生成词法分析器的工具。
30. 语法分析器生成器(Parser Generator):自动生成语法分析器的工具。
31. 静态单赋值(Static Single Assignment):将每个变量定义只赋值一次的形式化表示。
32. 可达性分析(Reachability Analysis):确定程序中哪些代码可以被执行到。
33. 可用表达式分析(Available Expression Analysis):确定在某个位置哪些表达式的值可用。
34. 活跃变量分析(Liveness Analysis):确定在某个位置哪些变量的值是活跃的。
35. 异常处理(Exception Handling):处理程序运行过程中可能出现的异常情况。
36. 动态编译(Dynamic Compilation):在程序运行时进行编译的过程。
37. 反汇编(Disassembly):将目标代码转换为汇编代码的过程。
38. 代码注释(Code Annotation):在源代码或目标代码中添加的注释信息。
39. 重定位(Relocation):调整目标代码中的地址引用以适应不同的内存布局。
40. 模拟器(Simulator):模拟特定计算机体系结构的软件工具。
41. 链接器(Linker):将多个目标代码文件和库文件合并为可执行文件的工具。
42. 目标文件(Object File):编译后生成的包含二进制机器代码的文件。
43. 静态链接(Static Linking):将所有依赖的库文件和目标代码合并为单个可执行文件。
44. 动态链接(Dynamic Linking):在程序运行时将依赖的库文件加载到内存中。
45. 共享库(Shared Library):可以在多个程序之间共享的目标代码的集合。
46. 静态库(Static Library):将多个目标代码文件打包为一个文件的集合。
47. 代码重用(Code Reusability):通过使用库和模块来避免重复编写代码。
48. 并行编译(Parallel Compilation):使用多个处理器同时编译代码的过程。
49. 死代码消除(Dead Code Elimination):移除不会被执行的代码以减少目标代码大小。
50. 缓存优化(Cache Optimization):优化代码以最大化处理器缓存的使用。
51. 代码验证(Code Verification):检查目标代码是否符合规范和预期行为。
52. 翻译过程(Translation Process):从源代码到目标代码的完整编译过程。
53. 程序语言(Programming Language):用于编写软件的形式化语言。
54. 前端(Frontend):编译过程中处理源代码的部分,包括词法分析和语法分析。
55. 后端(Backend):编译过程中处理目标代码的部分,包括代码优化和目标代码生成。
56. 高级语言(High-Level Language):抽象程度较高的程序设计语言,如C、Java等。
57. 低级语言(Low-Level Language):抽象程度较低的程序设计语言,如汇编语言。
58. 可移植性(Portability):程序在不同平台上的可运行性和一致性。
59. 抽象语法树(Abstract Syntax Tree):以树形结构表示程序的语法和语义。
60. 翻译单元(Translation Unit):编译器处理的源代码的最小单元,如一个文件。
61. 符号解析(Symbol Resolution):确定标识符引用的具体实体或地址的过程。
62. 代码回填(Code Backpatching):在代码生成过程中,将待定的地址或值替换为准确的值。
63. 模块化设计(Modular Design):将程序划分为模块以提高可维护性和复用性。
64. 依赖关系(Dependency):模块之间的相互依赖关系,一个模块的修改可能会影响其他模块。
65. 弱符号(Weak Symbol):在链接过程中可以被重定向或重定义的符号。
66. 强符号(Strong Symbol):在链接过程中不能被重定向或重定义的符号。
67. 前向引用(Forward Reference):在代码中引用尚未定义的标识符。
68. 静态作用域(Static Scope):在编译时确定变量访问范围的规则。
69. 动态作用域(Dynamic Scope):在运行时确定变量访问范围的规则。
70. 词法作用域(Lexical Scope):变量的可见性和访问范围由源代码的位置决定。
71. 作用域解析(Scope Resolution):确定标识符引用的具体作用域和实体的过程。
72. 符号重定位(Symbol Relocation):将目标代码中的符号引用与实
73. 汇编器(Assembler):将汇编语言代码转换为目标代码的工具。
74. 可重入代码(Reentrant Code):可以同时被多个线程或进程执行的代码。
75. 嵌入式系统(Embedded System):集成在其他设备中的计算机系统,通常具有特定的功能和限制。
76. 编译原理实践(Compiler Implementation):根据编译原理设计和实现编译器的过程。
77. 中断处理(Interrupt Handling):处理硬件或软件中断的过程。
78. 调试器(Debugger):用于调试和跟踪程序执行的工具。
79. 正则表达式(Regular Expression):描述字符串模式的表达式。
80. 后向引用(Backreference):在正则表达式中引用先前匹配的子字符串。
81. 有限自动机(Finite Automaton):描述正则语言的抽象计算模型。
82. 上下文有关文法(Context-Sensitive Grammar):在规则中考虑上下文信息的文法。
83. 重编译(Recompilation):在代码修改后重新进行编译的过程。
84. 嵌套函数(Nested Functions):在函数内部定义的函数。
85. 非终结符(Nonterminal):在文法中表示语法结构的符号。
86. 终结符(Terminal):在文法中表示基本语法单元的符号,如关键字、标识符等。
87. 归约(Reduction):将输入串和文法规则进行匹配并生成语法树的过程。
88. 属性计算(Attribute Computation):在归约过程中计算和传递属性值的过程。
89. 语义错误(Semantic Error):程序中违反语义规则导致的错误。
90. 语法错误(Syntax Error):程序中违反语法规则导致的错误。
91. 词法错误(Lexical Error):程序中违反词法规则导致的错误。
92. 基本块(Basic Block):没有分支和跳转语句的一组连续指令。
93. 程序切片(Program Slicing):根据特定的准则提取程序的子集以进行分析。
94. 变量活跃度(Variable Liveness):在程序执行过程中变量的读写状态。
95. 可用性分析(Availability Analysis):确定程序中哪些变量在某个位置可用。
96. 递归下降子程序(Recursive Descent Subroutine):用于实现递归下降分析的子程序。
97. 优化目标(Optimization Objective):优化过程中要达到的特定目标,如性能、功耗等。
98. 代码分块(Code Partitioning):将程序分割为不同的模块以进行并行编译。
99. 动态调度(Dynamic Scheduling):在运行时动态调整指令的执行顺序以提高性能。
100. 异常传播(Exception Propagation):在程序中传递和处理异常的过程。
提问工程
当面访谈一位计算机编译原理领域的资深专家是一个宝贵的机会。以下是20个高质量的问题,涵盖了该领域的不同方面:
1. 请您介绍一下您在计算机编译原理领域的专业背景和经验。
2. 在您看来,编译原理在计算机科学中的重要性是什么?它对于软件开发和性能优化有何影响?
3. 在编译原理领域,有哪些经典的编译器实现或项目案例?您认为它们有什么突出之处?
4. 当前编译器技术的发展趋势是什么?有哪些新兴技术或领域值得关注?
5. 在教授编译原理课程时,您通常会强调哪些核心概念和关键技术?
6. 在您的经验中,学生们在学习编译原理时最常遇到的困难是什么?您是如何帮助他们克服这些困难的?
7. 除了课程内容,您是否推荐学生参考一些经典的编译原理教材或资源?
8. 在实际应用中,编译原理有哪些具体的用途和重要性?您是否参与过相关的实际项目?
9. 在教学编译原理时,您如何平衡理论和实践的比重?有哪些实践项目或实验活动可以增强学生的理解和技能?
10. 当今编译器在多核处理器和分布式系统中的并行编译技术方面有何挑战和进展?
11. 在编译器优化方面,您认为哪些技术和策略对于提高程序性能最为有效?请分享一些实际案例。
12. 在您的研究或实践中,有哪些有趣的编译器相关项目或成果?请分享一些您的经验。
13. 您如何评估学生在编译原理方面的学习成果?在教学中使用了哪些评估方法和工具?
14. 除了编译器设计和优化,编译原理还涉及哪些相关领域或交叉学科?它们与编译原理有何关联?
15. 对于有志于从事编译器研究或开发工作的学生,您有哪些建议和指导?
16. 您是否参与过开源编译器项目或标准化组织?请分享您的经验和观点。
17您认为自动优化在编译器中的作用有多大?有哪些自动优化技术或工具值得关注?
18. 在您的职业生涯中,有哪些编译原理方面的挑战或问题给您留下了深刻印象?您是如何解决这些问题的?
19. 您认为学生们在课程结束后应该继续深入学习哪些编译原理的主题或技术?
20. 您认为计算机编译原理领域对于未来的发展和创新有何重要影响?它如何推动计算机科学的进步?
题目
1. 什么是编译器?它的作用是什么?
- 编译器是将高级程序语言转换为低级机器语言的程序。它的作用是将源代码翻译成可执行的目标代码。
2. 编译过程的基本阶段是什么?
- 编译过程包括词法分析、语法分析、语义分析、中间代码生成、代码优化和目标代码生成等阶段。
3. 什么是词法分析?其主要任务是什么?
- 词法分析是将源代码分解为词法单元的过程。主要任务是识别关键字、标识符、常量和运算符等词法单元。
4. 正则表达式在词法分析中的作用是什么?
- 正则表达式用于描述词法单元的模式,帮助词法分析器识别和提取源代码中的词法单元。
5. 有限自动机在词法分析中的作用是什么?
- 有限自动机用于根据正则表达式生成词法分析器,帮助识别并匹配源代码中的词法单元。
6. 什么是语法分析?其主要任务是什么?
- 语法分析是根据语法规则构建语法树的过程。主要任务是检查源代码的语法正确性。
7. 上下文无关文法是什么?如何表示和使用上下文无关文法?
- 上下文无关文法是一种形式化的语法表示工具,由产生式和非终结符组成。通常使用巴克斯范式(BNF)或扩展巴克斯范式(EBNF)表示。
8. 自顶向下分析是什么?如何进行自顶向下分析?
- 自顶向下分析是从根节点开始构建语法树的过程。它从起始符号开始,根据文法规则选择合适的产生式,逐步构建语法树。
9. 自底向上分析是什么?如何进行自底向上分析?
- 自底向上分析是从叶子节点开始归约为更高层次非终结符的过程。它根据输入符号串和文法规则,逐步归约为文法的起始符号。
10. 什么是语义分析?其主要任务是什么?
- 语义分析是对源代码进行语义检查的过程。主要任务包括类型检查、语义动作执行和符号表管理。
11. 类型检查的目的是什么?如何进行类型检查?
- 类型检查的目的是验证表达式和操作符之间的类型是否匹配。它根据语言的类型规则,检查源代码中的类型错误。
12. 语义动作是什么?它在语义分析中的作用是什么?
- 语义动作是在语法分析过程中执行的操作。它可以计算和维护语义信息,如计算表达式的值或生成中间代码。
13. 符号表是什么?它在语义分析中的作用是什么?
- 符号表是记录程序中的变量、函数和其他符号信息的数据结构。它用于存储和管理符号的属性和位置。
14. 什么是中间代码生成?为什么需要中间代码?
- 中间代码生成将源代码转换为一种中间表示形式。它为后续的代码优化和代码生成提供一个可操作的中间阶段。
15. 什么是三地址代码?它的结构是怎样的?
- 三地址代码是一种简化的中间代码表示形式。它的每条指令最多包含三个操作数,并且每个操作数都可以是变量、常量或标签。
16. 什么是抽象语法树?它在中间代码生成中的作用是什么?
- 抽象语法树是一种以树形结构表示源代码语法的抽象表示形式。它在中间代码生成中用于存储和操作源代码的结构和语义信息。
17. 代码优化的目的是什么?常见的代码优化技术有哪些?
- 代码优化的目的是提高程序的性能和效率。常见的代码优化技术包括常量传播、公共子表达式消除和循环优化等。
18. 常量传播是什么?它的作用是什么?
- 常量传播是将表达式中的常量直接替换为计算结果的优化技术。它可以减少程序中的运算次数,提高执行效率。
19. 公共子表达式消除是什么?它的作用是什么?
- 公共子表达式消除是消除多次出现的相同子表达式的优化技术。它可以减少重复计算,提高程序的执行效率。
20. 循环优化是什么?它的作用是什么?
- 循环优化是对循环结构进行优化的技术。它通过改变循环结构或代码重排等方式,提高循环的执行效率。
21. 代码生成的目的是什么?常见的代码生成方法有哪些?
- 代码生成的目的是将中间代码转换为目标机器代码。常见的代码生成方法包括基于树的代码生成和基于图的代码生成。
22. 基于树的代码生成是如何进行的?它的优缺点是什么?
- 基于树的代码生成是通过遍历抽象语法树生成目标机器代码。它的优点是简单易懂,但可能生成冗余的代码。
23. 基于图的代码生成是如何进行的?它的优缺点是什么?
- 基于图的代码生成是通过构建控制流图和数据流图生成目标机器代码。它的优点是可以进行更复杂的优化,但实现更复杂。
24. 寄存器分配是什么?它的目的是什么?
- 寄存器分配是将变量分配到处理器寄存器的过程。它的目的是减少内存访问次数,提高程序的执行速度。
25. 指令选择是什么?它在代码生成中的作用是什么?
- 指令选择是选择合适的目标机器指令来实现中间代码的转换。它根据目标机器的指令集和约束,生成有效的目标机器代码。
26. 数据流分析是什么?它在编译优化中的作用是什么?
- 数据流分析是对程序执行过程中数据流的特性进行推导和分析的过程。它可以用于优化程序的执行速度和内存使用。
27. 活跃变量分析是什么?它在代码优化中的作用是什么?
- 活跃变量分析用于确定在程序的每个位置上,哪些变量的值在稍后的执行中可能会使用。它可以用于优化寄存器分配和存储管理。
28. 内联展开是什么?它的作用是什么?
- 内联展开是将函数调用的代码插入到调用处,以减少函数调用的开销和提高执行效率。
29. 基本块是什么?它在代码优化中的作用是什么?
- 基本块是一段连续的代码片段,其中没有跳转指令。它可以用于分析和优化程序的控制流和数据流。
30. 常量折叠是什么?它的作用是什么?
- 常量折叠是将程序中的常量表达式在编译时计算并替换为其结果的优化技术。它可以减少运行时的计算开销。
31. 全局优化是什么?它在代码优化中的作用是什么?
- 全局优化是对整个程序进行优化的过程。它可以跨越多个基本块和函数,提高程序的执行效率和资源利用率。
32. 静态单赋值形式是什么?它在代码优化中的作用是什么?
- 静态单赋值形式是一种中间表示形式,每个变量在程序中只被赋值一次。它可以简化数据流分析和优化的实现。
33. 代码重排是什么?它的作用是什么?
- 代码重排是改变程序中指令的执行顺序,以优化程序的执行效率和内存访问模式。
34. 函数内联是什么?它的作用是什么?
- 函数内联是将函数调用处的代码替换为函数体的过程。它可以减少函数调用的开销和提高程序的执行效率。
35. 迭代求解是什么?它在代码优化中的作用是什么?
- 迭代求解是通过多次迭代优化过程来改善程序性能的方法。它可以在每次迭代中应用不同的优化技术,以达到更好的结果。
36. 虚拟机是什么?它在编译器中的作用是什么?
- 虚拟机是一种软件模拟的计算机,可以执行中间代码。它在编译器中用于测试和调试生成的目标代码。
37. 基于约束的寄存器分配是什么?它的作用是什么?
- 基于约束的寄存器分配是一种寄存器分配方法,通过考虑约束条件,为变量分配寄存器。它可以优化寄存器的使用和程序的执行效率。
38. 指针分析是什么?它在代码优化中的作用是什么?
- 指针分析是确定指针变量指向的内存位置和可能的别名关系的过程。它可以用于优化内存访问和消除不必要的指针操作。
39. 垃圾回收是什么?它在编译器中的作用是什么?
- 垃圾回收是自动管理动态分配内存的过程。它在编译器中用于回收不再使用的内存,以避免内存泄漏和提高程序的稳定性。
40. 数据流分析框架是什么?它在编译优化中的作用是什么?
- 数据流分析框架是一种
分析和优化程序的框架。它提供了抽象和可扩展的接口,用于定义和实现各种数据流分析算法。
41. 活性变量分析是什么?它在代码优化中的作用是什么?
- 活性变量分析用于确定在程序的每个位置上,哪些变量的值在稍后的执行中可能会使用。它可以用于优化寄存器分配和存储管理。
42. 静态分支预测是什么?它在代码优化中的作用是什么?
- 静态分支预测是通过静态分析程序的结构和语义,预测分支指令的执行路径。它可以提高分支预测的准确性和程序的执行效率。
43. 动态分支预测是什么?它在代码优化中的作用是什么?
- 动态分支预测是根据程序的运行时信息,预测分支指令的执行路径。它可以减少分支指令的等待时间,提高程序的执行效率。
44. 指令调度是什么?它的作用是什么?
- 指令调度是重新安排指令的执行顺序,以提高指令级并行性和程序的执行效率。
45. 循环展开是什么?它的作用是什么?
- 循环展开是将循环体内的代码复制多次以减少循环开销的优化技术。它可以减少循环控制的指令和分支指令,提高程序的执行效率。
46. 循环不变代码外提是什么?它的作用是什么?
- 循环不变代码外提是将循环中的不依赖循环变量的代码移到循环外部的优化技术。它可以减少循环内部的重复计算,提高程序的执行效率。
47. 指令级并行是什么?它在代码优化中的作用是什么?
- 指令级并行是指多个指令在同一时钟周期内并行执行的能力。它可以提高程序的执行效率和吞吐量。
48. 过程间分析是什么?它在编译优化中的作用是什么?
- 过程间分析是对整个程序的多个过程进行分析的过程。它可以提供全局的信息和优化机会,提高程序的执行效率和资源利用率。
49. 链接器是什么?它在编译过程中的作用是什么?
- 链接器是将多个目标文件合并为可执行文件的程序。
它的作用是解决符号引用和地址重定位等问题,使得程序可以正确地执行。
50. 编译器优化级别是什么?常见的优化级别有哪些?
- 编译器优化级别是编译器在生成目标代码时应用的优化策略和算法的级别。常见的优化级别包括-O0、-O1、-O2、-O3等,级别越高优化效果越明显,但编译时间也可能增加。
相关书籍
《编译原理》(龙书)
- 引言和背景知识
- 编译器的作用和重要性
- 编译过程的阶段
- 编译器设计中的关键问题
- 词法分析
- 正则表达式:一种描述文本模式的工具,用于定义词法单元的模式
- 有限自动机:一种能够识别正则语言的计算模型,用于将源代码分割为词法单元
- 词法分析器生成器:辅助工具,根据正则表达式生成词法分析器的代码
- 语法分析
- 上下文无关文法:一种形式化表示语法的工具,由产生式和非终结符组成
- 自顶向下分析:从根节点开始,逐步构建语法树的过程
- 自底向上分析:从叶子节点开始,逐步归约为更高层次的非终结符的过程
- 语义分析
- 类型检查:检查程序中表达式和操作符的类型是否匹配
- 语义动作:对语法树节点执行的操作,用于计算和维护语义信息
- 符号表管理:记录程序中的变量、函数和其它符号的信息,以支持语义分析
- 中间代码生成
- 三地址代码:一种简化的中间表示形式,每条指令最多有三个操作数
- 抽象语法树:一种以树形结构表示源代码语法的抽象表示形式
- 代码优化
- 常量传播:将表达式中的常量直接替换为计算结果,减少运算次数
- 公共子表达式消除:消除多次出现的相同子表达式,减少重复计算
- 循环优化:对循环结构进行优化,如循环展开和循环不变代码外提
- 代码生成
- 基于树的代码生成:基于语法树进行代码生成的方法
- 基于图的代码生成:基于控制流图和数据流图进行代码生成的方法
- 寄存器分配:分配寄存器给程序中的变量
- 指令选择:选择合适的机器指令来实现中间代码的操作
- 代码布局:将指令安排在内存中的布局,以提高执行效率
知识大纲
I. 编译原理概述
A. 概念:编译器、编译原理、编译过程
B. 意义:将高级程序语言转化为计算机可执行代码
C. 实现:词法分析、语法分析、语义分析、代码生成、代码优化
II. 词法分析
A. 概念:词法单元、正则表达式、有限自动机
B. 意义:将输入程序分割为词法单元序列
C. 实现:正则表达式的定义和转换为有限自动机、有限自动机的构建和模拟
III. 语法分析
A. 概念:上下文无关文法、LL(1)文法、LR(1)文法
B. 意义:构建语法树,检查语法正确性
C. 实现:文法的定义和表示、LL(1)文法的分析表构建、预测分析、语法树的构建
IV. 语义分析
A. 概念:语义动作、符号表、类型检查
B. 意义:检查语义正确性、生成中间代码
C. 实现:语义动作的定义和执行、符号表的构建和维护、类型检查算法
V. 中间代码生成
A. 概念:中间代码、三地址码、四元式
B. 意义:将源程序转化为中间表示形式
C. 实现:中间代码的生成、中间代码的优化、三地址码和四元式的表示
VI. 代码生成
A. 概念:目标代码、寄存器分配、指令选择
B. 意义:将中间代码转化为目标机器代码
C. 实现:目标代码的生成、寄存器分配算法、指令选择算法
VII. 代码优化
A. 概念:优化技术、局部优化、全局优化
B. 意义:提高程序执行效率、减少资源占用
C. 实现:局部优化技术(如常量传播、公共子表达式消除)、全局优化技术(如数据流分析、循环优化)
VIII. 循环和递归
A. 概念:循环结构、递归结构、迭代下降、自顶向下
B. 意义:编译器的主要算法思想
C. 实现:循环结构的实现、递归结构的实现、迭代下降解析算法、自顶向下的语法分析
第十章
引言
深度学习的目标是发现能够表示人工智能应用中各种数据概率分布的丰富、分层模型。
目前,深度学习在判别模型方面取得了显著成功。
深度生成模型由于在最大似然估计和相关策略中存在难以近似处理的概率计算问题,以及在生成环境中难以利用分段线性单元的优势,影响较小。
提出一种新的生成模型估计方法,避开了这些困难。
相关工作
过去大部分深度生成模型的研究集中在提供概率分布函数参数化的模型上。
提出了一种生成机制,不需要显式表示概率似然,但能够从所需分布中生成样本。
引入生成随机网络,可以使用精确的反向传播进行训练,而无需像Boltzmann机器那样进行大量的近似。
该工作通过消除生成随机网络中使用的马尔可夫链扩展了生成机制的思想。
对抗网络
对抗模型框架最直接的应用方式是在模型均为多层感知器时进行。
生成模型G学习数据x的分布pg,定义输入噪声变量pz(z)和映射G(z; θg),其中G是一个具有参数θg的可微函数,表示将输入噪声映射到数据空间。
判别模型D(x; θd)也是一个多层感知器,输出一个标量,表示x来自数据而非pg的概率。
训练D使其最大化对训练样本和G生成样本进行正确分类的概率。
同时训练G使其最小化log(1 − D(G(z)))。即,D和G在以下两人零和博弈中起作用,其价值函数为V(D, G): min G max D V(D, G) = Ex∼pdata(x)[log D(x)] + Ez∼pz(z)[log(1 − D(G(z)))]
在接下来的部分中,我们将展示对抗网络的理论分析,从而证明当G和D具备足够的容量时,训练准则可以恢复数据生成分布,即在非参数限制下。
在实践中,我们需要使用迭代的数值方法实现这个博弈。在训练的内循环中完全优化D在计算上是不可行的,并且对于有限的数据集会导致过拟合。
因此,我们采用交替优化D和一步优化G的方法。这样可以使D保持接近其最优解,只要G变化足够缓慢。具体过程详见算法1。
在实践中,方程式1可能无法为G提供足够的梯度以进行良好的学习。在学习的早期,当G较差时,D可以通过高置信度拒绝样本,因为它们与训练数据明显不同。
在这种情况下,log(1 − D(G(z)))会饱和。因此,我们可以将G的训练目标改为最大化log D(G(z))。这个目标函数在G和D的动态过程中得到相同的固定点,但在学习早期提供了更强的梯度。
编译原理
- 引言
- 编译器的定义和作用
编译器:将高级语言代码转换为低级语言(机器语言)的程序。
作用:代码翻译、优化、执行效率提升。
- 解释器与编译器的区别
解释器:逐行解释执行高级语言代码,不生成目标代码。
区别:编译器一次性转换;解释器逐行执行;运行速度差异。
- 编译器的组成和结构
组成:词法分析、语法分析、语义分析、中间代码生成、代码优化、目标代码生成。
结构:前端(分析)、后端(优化、生成)。
题目
1. 编译器的定义和作用
- 什么是编译器?请解释其作用。
- 编译器如何帮助提高代码执行的效率?
- 请描述编译器在代码翻译过程中的主要工作。
2. 解释器与编译器的区别
- 解释器是什么?它与编译器有什么区别?
- 为何解释器在执行高级语言代码时不生成目标代码?
- 在运行速度方面,编译器和解释器通常有何差异?为什么会有这种差异?
3. 编译器的组成和结构
- 编译器主要由哪些部分组成?每部分的作用是什么?
- 请解释“前端”和“后端”在编译器结构中的含义和职责。
- 在编译器的组成中,哪一部分负责中间代码的生成?为什么需要生成中间代码?
- 为什么编译器需要进行代码优化?它在哪个阶段进行,优化的过程是怎样的?
- 什么是目标代码?编译器在哪个阶段进行目标代码的生成?
- 词法分析(扫描器)
- 词法分析的目的
词法分析:源代码分解为词素(tokens)。
目的:拆分代码、消除空白、注释。
- 有限自动机:
确定性有限自动机(DFA)
非确定性有限自动机(NFA)
- 正则表达式
描述词素模式
定义规则
- 词法分析器生成工具:例如 Lex 和 Flex
题目
1. 词法分析的目的
- 词法分析是什么?它的主要目的是什么?
- 什么是词素(token)?在词法分析中,词素的作用是什么?
- 词法分析如何帮助消除源代码中的空白和注释?
2. 有限自动机:
- 什么是确定性有限自动机(DFA)?它在词法分析中的作用是什么?
- 非确定性有限自动机(NFA)和确定性有限自动机(DFA)之间的主要区别是什么?
- 如何利用有限自动机进行词法分析?
3. 正则表达式
- 正则表达式如何描述词素模式?
- 为什么要在词法分析中使用正则表达式?
- 如何用正则表达式定义规则?
4. 词法分析器生成工具:例如 Lex 和 Flex
- Lex和Flex是什么?它们的主要功能是什么?
- 如何使用Lex或Flex生成词法分析器?
- Lex和Flex在词法分析中的优点是什么?
- 语法分析(解析器)
- 语法分析的目的
语法树、抽象语法树、语法规则。
- 上下文无关文法
非终结符、终结符、产生式、开始符号。
- 递归下降解析
自顶向下、消除左递归
- 自顶向下解析:
预测分析表
LL(1) 文法
- 自底向上解析:
操作符优先文法、
LR 解析、
LALR 解析、
SLR 解析
- 语法分析器生成工具:
Yacc、Bison。
题目
1. 语法分析的目的
- 什么是语法分析?它的主要目的是什么?
- 什么是语法树和抽象语法树?它们在语法分析中的作用是什么?
- 语法规则在语法分析中的作用是什么?
2. 上下文无关文法
- 什么是上下文无关文法?它在编译器设计中的重要性是什么?
- 定义上下文无关文法需要哪些元素?请分别解释非终结符、终结符、产生式和开始符号的含义。
3. 递归下降解析
- 什么是递归下降解析?它的工作原理是什么?
- 为什么需要消除左递归?如何消除左递归?
4. 自顶向下解析:
- 什么是预测分析表?在自顶向下解析中,预测分析表的作用是什么?
- 什么是LL(1)文法?它与自顶向下解析的关系是什么?
5. 自底向上解析:
- 请解释操作符优先文法、LR解析、LALR解析和SLR解析的基本概念和工作原理。
- 自底向上解析与自顶向下解析的主要区别是什么?
6. 语法分析器生成工具:
- Yacc和Bison是什么?它们的主要功能是什么?
- 如何使用Yacc或Bison生成语法分析器?
- Yacc和Bison在语法分析中的优点是什么?
- 语义分析
- 语义分析的目的
语义规则、静态语义
- 属性文法
继承属性、合成属性。
- 类型检查:
例如类型推导、
类型兼容性
- 符号表管理
作用域、查找、插入
题目
1. 语义分析的目的
- 语义分析的主要目标是什么?
- 请解释什么是语义规则以及静态语义,它们在语义分析中的作用是什么?
2. 属性文法
- 什么是属性文法?它如何帮助进行语义分析?
- 请解释继承属性和合成属性的含义,以及它们在属性文法中的作用。
3. 类型检查:
- 什么是类型检查?为什么它在语言编译中是必要的?
- 请解释类型推导和类型兼容性在类型检查中的作用。
- 在语言编译中,如果没有进行适当的类型检查,可能会导致哪些问题?
4. 符号表管理
- 符号表在编译器中的作用是什么?
- 请解释什么是作用域,它如何影响符号表的管理?
- 描述符号表的查找和插入过程,以及在这些过程中可能遇到的挑战。
- 中间代码生成
- 三地址代码
操作数、运算符、目标
- 四元式表示法
操作数1、操作数2、运算符、结果
- 语法制导翻译
翻译规则、翻译模式
- 基本块和流图
基本块、控制流图、节点、边
题目
- 代码优化
- 优化的目的
性能、空间
- 局部优化:
常量折叠、
代数简化、
公共子表达式消除
- 全局优化:
循环不变式外提、
死代码消除、
强度削弱
- 数据流分析:
可用表达式分析、
活跃变量分析、
循环依赖分析
- 目标代码生成
- 目标代码生成的目的
机器语言、汇编语言
- 指令选择和寻址模式
指令集、寻址方式
- 寄存器分配:
图着色法、线性扫描
- 指令调度和流水线优化
指令排序、流水线冲突