导图社区 多模态RAG
多模态RAG
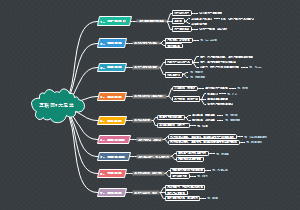
多模态 RAG 是推动 AI 从单纯内容生成走向 Agent 智能体的关键路径,本次思维导图分享完整拆解迪士尼 RAG 助手的全链路构建流程。项目以搭建多模态 RAG 系统为核心,可处理文本、图片、视频等多种格式数据,解决非结构化数据处理、跨模态知识召回难题。流程分为三大核心阶段:首先是数据解析与向量化,对 Word、PDF 等文档解析,依托多模态 Embedding 模型,将文本、图像、视频转化为统一维度向量;其次构建统一 FAISS 向量索引,把不同模态向量存入同一向量空间,实现跨模态检索;同时搭配多种文档切片策略,切片作为检索质量基石,可按需选择方案优化召回效果。在查询推理环节,系统加入意图检测、相似度阈值过滤、智能 Query 处理,筛选有效检索素材,再交由大模型整合信息输出答案,实现 “以文搜图”“以图搜文”,让 AI 具备自主检索、筛选信息的能力,不再局限于简单生成文本。能力进一步延伸到 AI 辅助办公,可用于汇报材料制作,利用 AI 生成配图、借助 LLM 重塑工作流,高效产出图文素材。整套体系让 AI 拥有自主理解任务、检索外部资料、规划执行任务的能力,完成从被动生成到主动执行的转变。无论大模型开发学习者、AI 技术从业者,还是希望用 AI 优化汇报工作的职场人员,都可以参考这套落地方案。
提示: 本内容由社区用户上传并分享。平台不对内容的真实性、合法性、知识产权归属及是否侵害第三方权利进行事前审核或保证。本内容可能包含受版权保护的图片、字体或其他第三方素材,使用前请自行确认授权范围。
- 智能体
- AI Agent
- 多模态RAG
- AI辅助办公

- 可能替代RAG的技术
传统 RAG 遇挑战,三大替代技术谁主沉浮?本思维导图先剖析传统 RAG 固定流水线的本质缺陷,传统 RAG 依靠查询向量化、向量检索、拼接检索文本再送入大模型生成答案,整套流程固化,存在检索成本偏高、文本总结能力有限等短板,面对复杂企业知识库场景时容易出现信息遗漏、检索不准等问题。再深度解读超长上下文、Agentic Retrieval、LLM Wiki 三大技术及其适用边界。超长上下文技术依托大模型不断扩容的记忆容量,直接将完整文档作为输入,省去向量检索环节,适合小规模知识库,但存在 token 成本上涨、长文本中间信息遗忘等局限。Agentic Retrieval 智能体检索将检索升级为推理任务,构建思考、行动、观察的循环,依靠工具链自主规划、分步完成复杂查询,适配企业多步骤复杂检索需求。LLM Wiki 知识导航系统具备页面级语义存储、实体关系构建能力,支持知识动态更新,适合长期沉淀专业知识。最后给出技术选型指南,明确三大新技术并非全面取代 RAG,各自拥有适用场景与局限性,RAG 仍是企业级应用基石,企业可结合知识库规模、查询复杂度、成本预算灵活搭配方案。无论研究大模型应用的算法工程师、学习检索增强技术的研发人员,还是需要选型知识库方案的产品从业者,都可以借助这套分析框架理清 RAG 替代方案的技术逻辑。
- RAG高级技术与调优
如何提高 RAG 召回效率和精准度?本篇思维导图从知识库处理,到查询优化,到混合检索,再到精排召回,每一步都可以在不增加 LLM 负担的前提下提高召回质量。在知识库处理阶段,可通过知识库问题生成与检索向量化、对话知识沉淀、知识库质量校验、版本管理与性能对比,提前清洗、优化知识库内容,减少脏数据对检索的干扰,夯实底层数据基础。查询优化环节,采用多 Query 策略,借助大模型对原始查询进行改写、扩展,丰富检索维度,挖掘用户真实意图。检索层面使用混合检索策略,融合 BM25 关键词检索与向量检索,兼顾语义匹配与关键词命中,弥补单一检索方式的缺陷。检索完成后接入重排模型,对初步召回的候选文档做二次打分筛选,过滤无关片段,进一步提升结果精准度。导图还拓展了 GraphRAG 与 Agentic RAG 进阶方案,GraphRAG 依托知识图谱挖掘文本实体关联,适合复杂全局推理;Agentic RAG 将检索交给智能体,自主完成多轮检索规划。整套优化链路将工作量前置在检索环节,不额外增加大模型输入 token,减轻 LLM 处理压力。
- 多模态RAG
多模态 RAG 是推动 AI 从单纯内容生成走向 Agent 智能体的关键路径,本次思维导图分享完整拆解迪士尼 RAG 助手的全链路构建流程。项目以搭建多模态 RAG 系统为核心,可处理文本、图片、视频等多种格式数据,解决非结构化数据处理、跨模态知识召回难题。流程分为三大核心阶段:首先是数据解析与向量化,对 Word、PDF 等文档解析,依托多模态 Embedding 模型,将文本、图像、视频转化为统一维度向量;其次构建统一 FAISS 向量索引,把不同模态向量存入同一向量空间,实现跨模态检索;同时搭配多种文档切片策略,切片作为检索质量基石,可按需选择方案优化召回效果。在查询推理环节,系统加入意图检测、相似度阈值过滤、智能 Query 处理,筛选有效检索素材,再交由大模型整合信息输出答案,实现 “以文搜图”“以图搜文”,让 AI 具备自主检索、筛选信息的能力,不再局限于简单生成文本。能力进一步延伸到 AI 辅助办公,可用于汇报材料制作,利用 AI 生成配图、借助 LLM 重塑工作流,高效产出图文素材。整套体系让 AI 拥有自主理解任务、检索外部资料、规划执行任务的能力,完成从被动生成到主动执行的转变。无论大模型开发学习者、AI 技术从业者,还是希望用 AI 优化汇报工作的职场人员,都可以参考这套落地方案。
多模态RAG
社区模板帮助中心,点此进入>>
- 可能替代RAG的技术
传统 RAG 遇挑战,三大替代技术谁主沉浮?本思维导图先剖析传统 RAG 固定流水线的本质缺陷,传统 RAG 依靠查询向量化、向量检索、拼接检索文本再送入大模型生成答案,整套流程固化,存在检索成本偏高、文本总结能力有限等短板,面对复杂企业知识库场景时容易出现信息遗漏、检索不准等问题。再深度解读超长上下文、Agentic Retrieval、LLM Wiki 三大技术及其适用边界。超长上下文技术依托大模型不断扩容的记忆容量,直接将完整文档作为输入,省去向量检索环节,适合小规模知识库,但存在 token 成本上涨、长文本中间信息遗忘等局限。Agentic Retrieval 智能体检索将检索升级为推理任务,构建思考、行动、观察的循环,依靠工具链自主规划、分步完成复杂查询,适配企业多步骤复杂检索需求。LLM Wiki 知识导航系统具备页面级语义存储、实体关系构建能力,支持知识动态更新,适合长期沉淀专业知识。最后给出技术选型指南,明确三大新技术并非全面取代 RAG,各自拥有适用场景与局限性,RAG 仍是企业级应用基石,企业可结合知识库规模、查询复杂度、成本预算灵活搭配方案。无论研究大模型应用的算法工程师、学习检索增强技术的研发人员,还是需要选型知识库方案的产品从业者,都可以借助这套分析框架理清 RAG 替代方案的技术逻辑。
- RAG高级技术与调优
如何提高 RAG 召回效率和精准度?本篇思维导图从知识库处理,到查询优化,到混合检索,再到精排召回,每一步都可以在不增加 LLM 负担的前提下提高召回质量。在知识库处理阶段,可通过知识库问题生成与检索向量化、对话知识沉淀、知识库质量校验、版本管理与性能对比,提前清洗、优化知识库内容,减少脏数据对检索的干扰,夯实底层数据基础。查询优化环节,采用多 Query 策略,借助大模型对原始查询进行改写、扩展,丰富检索维度,挖掘用户真实意图。检索层面使用混合检索策略,融合 BM25 关键词检索与向量检索,兼顾语义匹配与关键词命中,弥补单一检索方式的缺陷。检索完成后接入重排模型,对初步召回的候选文档做二次打分筛选,过滤无关片段,进一步提升结果精准度。导图还拓展了 GraphRAG 与 Agentic RAG 进阶方案,GraphRAG 依托知识图谱挖掘文本实体关联,适合复杂全局推理;Agentic RAG 将检索交给智能体,自主完成多轮检索规划。整套优化链路将工作量前置在检索环节,不额外增加大模型输入 token,减轻 LLM 处理压力。
- 多模态RAG
多模态 RAG 是推动 AI 从单纯内容生成走向 Agent 智能体的关键路径,本次思维导图分享完整拆解迪士尼 RAG 助手的全链路构建流程。项目以搭建多模态 RAG 系统为核心,可处理文本、图片、视频等多种格式数据,解决非结构化数据处理、跨模态知识召回难题。流程分为三大核心阶段:首先是数据解析与向量化,对 Word、PDF 等文档解析,依托多模态 Embedding 模型,将文本、图像、视频转化为统一维度向量;其次构建统一 FAISS 向量索引,把不同模态向量存入同一向量空间,实现跨模态检索;同时搭配多种文档切片策略,切片作为检索质量基石,可按需选择方案优化召回效果。在查询推理环节,系统加入意图检测、相似度阈值过滤、智能 Query 处理,筛选有效检索素材,再交由大模型整合信息输出答案,实现 “以文搜图”“以图搜文”,让 AI 具备自主检索、筛选信息的能力,不再局限于简单生成文本。能力进一步延伸到 AI 辅助办公,可用于汇报材料制作,利用 AI 生成配图、借助 LLM 重塑工作流,高效产出图文素材。整套体系让 AI 拥有自主理解任务、检索外部资料、规划执行任务的能力,完成从被动生成到主动执行的转变。无论大模型开发学习者、AI 技术从业者,还是希望用 AI 优化汇报工作的职场人员,都可以参考这套落地方案。
- 相似推荐
- 大纲