导图社区 机器学习hw1-决策树
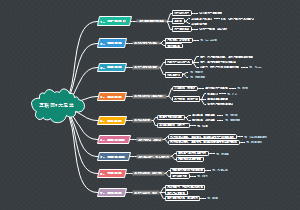
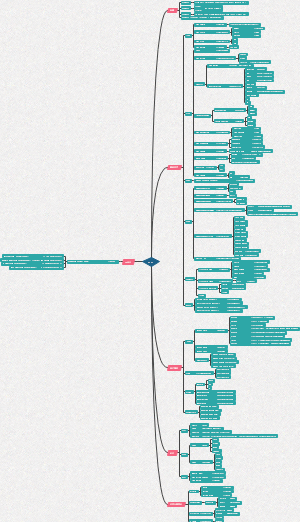
这是一篇关于机器学习hw1的思维导图,以英雄联盟对局胜负预测任务为核心,完整呈现从任务介绍到模型调优的全流程。任务介绍部分讲解英雄联盟游戏背景,说明数据集来源与构成,数据集包含大量高阶段位对局样本,依据对局前十分钟特征预测红蓝双方胜负,要求完成决策树算法代码编写,理解机器学习完整工作流程。内容依次拆解各个实操环节:导入工具包,介绍 pandas、numpy、sklearn 等核心库的用途;读入数据,说明 csv 数据集读取方式,讲解标签与特征字段含义;数据概览,讲解数据查看、统计分析方法,识别重复、冗余特征;增删特征,介绍特征筛选、构造差值特征的思路;特征离散化,针对连续数值特征做分箱映射处理,适配决策树对离散特征的输入要求;数据集准备,划分训练集与测试集,转换数据格式适配模型输入;决策树模型的实现,要求补全代码完成决策树搭建;模型调优,讲解排查代码 bug、调整参数、优化算法的调试思路;最后的总结梳理完整机器学习任务链路:确定任务、数据分析、特征工程、数据集划分、模型设计、训练测试、结果分析,点明各阶段实践要点,同时提示初次建模效果往往不理想,需要迭代调试。整套内容理论结合实操,把数据集处理、特征工程、决策树建模串联,还原实战型机器学习作业完整步骤。无论机器学习课程学员、Python 数据分析学习者还是初学决策树算法的技术爱好者都可以借助这份导图梳理项目流程。
提示: 本内容由社区用户上传并分享。平台不对内容的真实性、合法性、知识产权归属及是否侵害第三方权利进行事前审核或保证。本内容可能包含受版权保护的图片、字体或其他第三方素材,使用前请自行确认授权范围。
这是一篇关于机器学习hw1的思维导图,以英雄联盟对局胜负预测任务为核心,完整呈现从任务介绍到模型调优的全流程。任务介绍部分讲解英雄联盟游戏背景,说明数据集来源与构成,数据集包含大量高阶段位对局样本,依据对局前十分钟特征预测红蓝双方胜负,要求完成决策树算法代码编写,理解机器学习完整工作流程。内容依次拆解各个实操环节:导入工具包,介绍 pandas、numpy、sklearn 等核心库的用途;读入数据,说明 csv 数据集读取方式,讲解标签与特征字段含义;数据概览,讲解数据查看、统计分析方法,识别重复、冗余特征;增删特征,介绍特征筛选、构造差值特征的思路;特征离散化,针对连续数值特征做分箱映射处理,适配决策树对离散特征的输入要求;数据集准备,划分训练集与测试集,转换数据格式适配模型输入;决策树模型的实现,要求补全代码完成决策树搭建;模型调优,讲解排查代码 bug、调整参数、优化算法的调试思路;最后的总结梳理完整机器学习任务链路:确定任务、数据分析、特征工程、数据集划分、模型设计、训练测试、结果分析,点明各阶段实践要点,同时提示初次建模效果往往不理想,需要迭代调试。整套内容理论结合实操,把数据集处理、特征工程、决策树建模串联,还原实战型机器学习作业完整步骤。无论机器学习课程学员、Python 数据分析学习者还是初学决策树算法的技术爱好者都可以借助这份导图梳理项目流程。
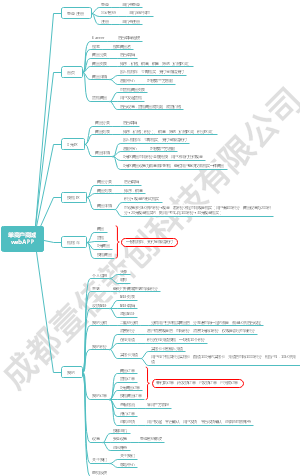
这是一篇关于机器学习思维导图,分为概念、经典方法、应用背景、机器学习基础、机器学习实验方法与原则五大模块。机器学习核心概念阐明学习的本质,介绍三要素与机器学习系统范例,区分传统机器学习与深度学习,讲解通用机器学习系统设计的完整流程,包含经验总结、目标函数设定、近似假设、学习算法选择与模型综合。经典方法涵盖决策树、回归分析、贝叶斯学习等主流算法。应用背景梳理数据挖掘、个性化推荐、各类识别任务等落地场景,列举多项行业实例,展现机器学习替代人力的实际价值。机器学习实验方法与原则是重点,包含回归、分类、特定任务的各类评价指标,介绍 MAE、MSE、RMSE、AUC‑ROC 等评估计算方式,同时详解数据集划分策略,训练集、验证集、测试集的用途,对比随机划分、固定划分等划分方式,介绍随机重复试验、k 折交叉验证等实验手段,强调保证评价指标独立分布,保障统计有效性,以此科学评估模型性能,规避实验偏差。无论计算机相关专业学生入门学习,还是技术从业者梳理机器学习知识,都可以使用这份思维导图。
这是一篇关于全国现货运行进度的思维导图,主要内容包括:正式运行,连续结算试运行,长周期结算试运行,短周期结算试运行,调电试运行,模拟试运行。
社区模板帮助中心,点此进入>>
这是一篇关于机器学习hw1的思维导图,以英雄联盟对局胜负预测任务为核心,完整呈现从任务介绍到模型调优的全流程。任务介绍部分讲解英雄联盟游戏背景,说明数据集来源与构成,数据集包含大量高阶段位对局样本,依据对局前十分钟特征预测红蓝双方胜负,要求完成决策树算法代码编写,理解机器学习完整工作流程。内容依次拆解各个实操环节:导入工具包,介绍 pandas、numpy、sklearn 等核心库的用途;读入数据,说明 csv 数据集读取方式,讲解标签与特征字段含义;数据概览,讲解数据查看、统计分析方法,识别重复、冗余特征;增删特征,介绍特征筛选、构造差值特征的思路;特征离散化,针对连续数值特征做分箱映射处理,适配决策树对离散特征的输入要求;数据集准备,划分训练集与测试集,转换数据格式适配模型输入;决策树模型的实现,要求补全代码完成决策树搭建;模型调优,讲解排查代码 bug、调整参数、优化算法的调试思路;最后的总结梳理完整机器学习任务链路:确定任务、数据分析、特征工程、数据集划分、模型设计、训练测试、结果分析,点明各阶段实践要点,同时提示初次建模效果往往不理想,需要迭代调试。整套内容理论结合实操,把数据集处理、特征工程、决策树建模串联,还原实战型机器学习作业完整步骤。无论机器学习课程学员、Python 数据分析学习者还是初学决策树算法的技术爱好者都可以借助这份导图梳理项目流程。
这是一篇关于机器学习思维导图,分为概念、经典方法、应用背景、机器学习基础、机器学习实验方法与原则五大模块。机器学习核心概念阐明学习的本质,介绍三要素与机器学习系统范例,区分传统机器学习与深度学习,讲解通用机器学习系统设计的完整流程,包含经验总结、目标函数设定、近似假设、学习算法选择与模型综合。经典方法涵盖决策树、回归分析、贝叶斯学习等主流算法。应用背景梳理数据挖掘、个性化推荐、各类识别任务等落地场景,列举多项行业实例,展现机器学习替代人力的实际价值。机器学习实验方法与原则是重点,包含回归、分类、特定任务的各类评价指标,介绍 MAE、MSE、RMSE、AUC‑ROC 等评估计算方式,同时详解数据集划分策略,训练集、验证集、测试集的用途,对比随机划分、固定划分等划分方式,介绍随机重复试验、k 折交叉验证等实验手段,强调保证评价指标独立分布,保障统计有效性,以此科学评估模型性能,规避实验偏差。无论计算机相关专业学生入门学习,还是技术从业者梳理机器学习知识,都可以使用这份思维导图。
这是一篇关于全国现货运行进度的思维导图,主要内容包括:正式运行,连续结算试运行,长周期结算试运行,短周期结算试运行,调电试运行,模拟试运行。
hw1
本次以英雄联盟对局胜负预测任务为基础,要求实现决策树算法相关细节,加深对算法的理解,并了解做机器学习任务的大致流程。
任务介绍
英雄联盟(League of Legends,LoL)是一个多人在线竞技游戏,由拳头游戏(Riot Games)公司出品。在游戏中,每位玩家控制一位有独特技能的英雄,红蓝两支队伍各有五位玩家进行对战,目标是摧毁对方的基地水晶。水晶有多座防御塔保护,通常需要先摧毁一些防御塔再摧毁水晶。玩家所控制的英雄起初非常弱,需要不断击杀小兵、野怪和对方英雄来获得金币、经验。经验可以提升英雄等级和技能等级,金币可以用来购买装备提升攻击、防御等属性。对战过程中一般没有己方单位在附近的地点是没有视野的,即无法看到对面单位,双方可以通过使用守卫来监视某个地点,洞察对面走向、制定战术。 本数据集来自
,包含了9879场钻一到大师段位的单双排对局,对局双方几乎是同一水平。每条数据是前10分钟的对局情况,每支队伍有19个特征,红蓝双方共38个特征。这些特征包括英雄击杀、死亡,金钱、经验、等级情况等等。一局游戏一般会持续30至40分钟,但是实际前10分钟的局面很大程度上影响了之后胜负的走向。作为最成功的电子竞技游戏之一,对局数据、选手数据的量化与研究具有重要意义,可以启发游戏将来的发展和改进。
本任务是希望同学们依据注释的要求,对代码中空缺部分进行填写,完成决策树模型的详细实现,根据已有的对局前10分钟特征信息,预测最后获胜方是蓝色方还是红色方,了解执行一个机器学习任务的大致流程,并提交代码和实验报告。第一次作业也是一个机器学习小实验的例子,之后的作业可能不再提供预处理等流程代码,由同学们自己设计实验完成代码编写。
导入工具包
pandas是数据分析和处理常用的工具包,非常适合处理行列表格数据。numpy是数学运算工具包,支持高效的矩阵、向量运算。sklearn是机器学习常用工具包,包括了一些已经实现好的简单模型和一些常用数据处理方法、评价指标等函数。
from collections import Counter import pandas as pd # 数据处理 import numpy as np # 数学运算 from sklearn.model_selection import train_test_split, cross_validate # 划分数据集函数 from sklearn.metrics import accuracy_score # 准确率函数 RANDOM_SEED = 2020 # 固定随机种子
读入数据
假设数据文件放在./data/目录下,标准的csv文件可以用pandas里的read_csv()函数直接读入。文件共有40列,38个特征(红蓝方各19),1个标签列(blueWins),和一个对局标号(gameId)。对局标号不是标签也不是特征,可以舍去。
csv_data = './data/high_diamond_ranked_10min.csv' # 数据路径 data_df = pd.read_csv(csv_data, sep=',') # 读入csv文件为pandas的DataFrame data_df = data_df.drop(columns='gameId') # 舍去对局标号列
数据概览
对于一个机器学习问题,在拿到任务和数据后,首先需要观察数据的情况,比如我们可以通过.iloc[0]取出数据的第一行并输出。不难看出每个特征都存成了float64浮点数,该对局蓝色方开局10分钟有小优势。同时也可以发现有些特征列是重复冗余的,比如blueGoldDiff表示蓝色队金币优势,redGoldDiff表示红色方金币优势,这两个特征是完全对称的互为相反数。blueCSPerMin是蓝色方每分钟击杀小兵数,它乘10就是10分钟所有小兵击杀数blueTotalMinionsKilled。在之后的特征处理过程中可以考虑去除这些冗余特征。 另外,pandas有非常方便的describe()函数,可以直接通过DataFrame进行调用,可以展示每一列数据的一些统计信息,对数据分布情况有大致了解,比如blueKills蓝色方击杀英雄数在前十分钟的平均数是6.14、方差为2.93,中位数是6,百分之五十以上的对局中该特征在4-8之间,等等。
print(data_df.iloc[0]) # 输出第一行数据 data_df.describe() # 每列特征的简单统计信息
增删特征
传统的机器学习模型大部分都是基于特征的,因此特征工程是机器学习中非常重要的一步。有时构造一个好的特征比改进一个模型带来的提升更大。这里简单展示一些特征处理的例子。首先,上面提到,特征列中有些特征信息是完全冗余的,会给模型带来不必要的计算量,可以去除。其次,相比于红蓝双方击杀、助攻的绝对值,可能双方击杀英雄的差值更能体现出当前对战的局势。因此,我们可以构造红蓝双方对应特征的差值。数据文件中已有的差值是金币差GoldDiff和经验差ExperienceDiff,实际上每个对应特征都可以构造这样的差值特征。
drop_features = ['blueGoldDiff', 'redGoldDiff', 'blueExperienceDiff', 'redExperienceDiff', 'blueCSPerMin', 'redCSPerMin', 'blueGoldPerMin', 'redGoldPerMin'] # 需要舍去的特征列 df = data_df.drop(columns=drop_features) # 舍去特征列 info_names = [c[3:] for c in df.columns if c.startswith('red')] # 取出要作差值的特征名字(除去red前缀) for info in info_names: # 对于每个特征名字 df['br' + info] = df['blue' + info] - df['red' + info] # 构造一个新的特征,由蓝色特征减去红色特征,前缀为br # 其中FirstBlood为首次击杀最多有一只队伍能获得,brFirstBlood=1为蓝,0为没有产生,-1为红 df = df.drop(columns=['blueFirstBlood', 'redFirstBlood']) # 原有的FirstBlood可删除
特征离散化
决策树ID3算法一般是基于离散特征的,本例中存在很多连续的数值特征,例如队伍金币。直接应用该算法每个值当作一个该特征的一个取值可能造成严重的过拟合,因此需要对特征进行离散化,即将一定范围内的值映射成一个值,例如对用户年龄特征,将0-10映射到0,11-18映射到1,19-25映射到2,25-30映射到3,等等类似,然后在决策树构建时使用映射后的值计算信息增益。
本小节要求实现特征离散化,请补全相关代码
discrete_df = df.copy() # 先复制一份数据 for c in df.columns[1:]: # 遍历每一列特征,跳过标签列 ''' 请离散化每一列特征,即discrete_df[c] = ... 提示: 对于有些特征本身取值就很少,可以跳过即 if ... : continue 对于其他特征,可以使用等区间离散化、等密度离散化或一些其他离散化方法 可参考使用pandas.cut或qcut '''
数据集准备
构建机器学习模型前要构建训练和测试的数据集。在本例中首先需要分开标签和特征,标签是不能作为模型的输入特征的,就好比作业和试卷答案不能在做题和考试前就告诉学生。测试一个模型在一个任务上的效果至少需要训练集和测试集,训练集用来训练模型的参数,好比学生做作业获得知识,测试集用来测试模型效果,好比期末考试考察学生学习情况。测试集的样本不应该出现在训练集中,否则会造成模型效果估计偏高,好比考试时出的题如果是作业题中出现过的,会造成考试分数不能准确衡量学生的学习情况,估计值偏高。划分训练集和测试集有多种方法,下面首先介绍的是随机取一部分如20%作测试集,剩下作训练集。sklearn提供了相关工具函数train_test_split。sklearn的输入输出一般为numpy的array矩阵,需要先将pandas的DataFrame取出为numpy的array矩阵。
all_y = discrete_df['blueWins'].values # 所有标签数据 feature_names = discrete_df.columns[1:] # 所有特征的名称 all_x = discrete_df[feature_names].values # 所有原始特征值,pandas的DataFrame.values取出为numpy的array矩阵 # 划分训练集和测试集 x_train, x_test, y_train, y_test = train_test_split(all_x, all_y, test_size=0.2, random_state=RANDOM_SEED) all_y.shape, all_x.shape, x_train.shape, x_test.shape, y_train.shape, y_test.shape # 输出数据行列信息
决策树模型的实现
本小节要求实现决策树模型,请补全算法代码
# 定义决策树类 class DecisionTree(object): def __init__(self, classes, features, max_depth=10, min_samples_split=10, impurity_t='entropy'): ''' 传入一些可能用到的模型参数,也可能不会用到 classes表示模型分类总共有几类 features是每个特征的名字,也方便查询总的共特征数 max_depth表示构建决策树时的最大深度 min_samples_split表示构建决策树分裂节点时,如果到达该节点的样本数小于该值则不再分裂 impurity_t表示计算混杂度(不纯度)的计算方式,例如entropy或gini ''' self.classes = classes self.features = features self.max_depth = max_depth self.min_samples_split = min_samples_split self.impurity_t = impurity_t self.root = None # 定义根节点,未训练时为空 ''' 请实现决策树算法,使得fit函数和predict函数可以正常调用,跑通之后的测试代码, 要求之后测试代码输出的准确率大于0.6。 提示: 可以定义额外一些函数,例如 impurity()用来计算混杂度 gain()调用impurity用来计算信息增益 expand_node()训练时递归函数分裂节点,考虑不同情况 1. 无需分裂 或 达到分裂阈值 2. 调用gain()找到最佳分裂特征,递归调用expand_node 3. 找不到有用的分裂特征 fit函数调用该函数返回根节点 traverse_node()预测时遍历节点,考虑不同情况 1. 已经到达叶节点,则返回分类结果 2. 该特征取值在训练集中未出现过 3. 依据特征取值进入相应子节点,递归调用traverse_node 当然也可以有其他实现方式。 ''' def fit(self, feature, label): assert len(self.features) == len(feature[0]) # 输入数据的特征数目应该和模型定义时的特征数目相同 ''' 训练模型 feature为二维numpy(n*m)数组,每行表示一个样本,有m个特征 label为一维numpy(n)数组,表示每个样本的分类标签 提示:一种可能的实现方式为 self.root = self.expand_node(feature, label, depth=1) # 从根节点开始分裂,模型记录根节点 ''' def predict(self, feature): assert len(feature.shape) == 1 or len(feature.shape) == 2 # 只能是1维或2维 ''' 预测 输入feature可以是一个一维numpy数组也可以是一个二维numpy数组 如果是一维numpy(m)数组则是一个样本,包含m个特征,返回一个类别值 如果是二维numpy(n*m)数组则表示n个样本,每个样本包含m个特征,返回一个numpy一维数组 提示:一种可能的实现方式为 if len(feature.shape) == 1: # 如果是一个样本 return self.traverse_node(self.root, feature) # 从根节点开始路由 return np.array([self.traverse_node(self.root, f) for f in feature]) # 如果是很多个样本 ''' # 定义决策树模型,传入算法参数 DT = DecisionTree(classes=[0,1], features=feature_names, max_depth=5, min_samples_split=10, impurity_t='gini') DT.fit(x_train, y_train) # 在训练集上训练 p_test = DT.predict(x_test) # 在测试集上预测,获得预测值 print(p_test) # 输出预测值 test_acc = accuracy_score(p_test, y_test) # 将测试预测值与测试集标签对比获得准确率 print('accuracy: {:.4f}'.format(test_acc)) # 输出准确率
模型调优
第一次模型测试结果可能不够好,可以先检查调试代码是否有bug,再尝试调整参数或者优化计算方法。
总结
一个完整的机器学习任务包括:确定任务、数据分析、特征工程、数据集划分、模型设计、模型训练和效果测试、结果分析和调优等多个阶段,本案例以英雄联盟游戏胜负预测任务为例,给出了每个阶段的一些简单例子,帮助大家入门机器学习,希望大家有所收获!