导图社区 Embedding与向量数据库
Embedding与向量数据库
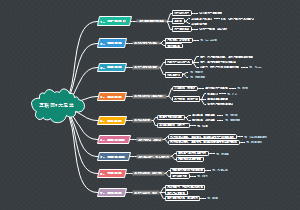
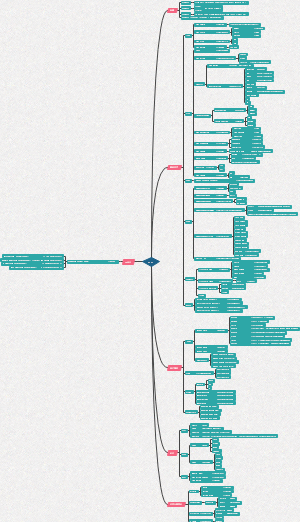
想入门 RAG 语义检索,首先就要搞懂 Embedding 与向量数据库这套基础体系。本思维导图先从 Embedding 技术开始逐层讲解,先回顾传统文本特征提取方案 TF‑IDF,厘清词频 TF、逆文档频率 IDF 的计算逻辑与固有局限;再过渡到 Word Embedding 词嵌入,讲解 Skip‑Gram、CBOW 两种训练模式,借助 king‑man+woman=queen 的向量类比特性,直观理解词向量的语义表达原理。之后围绕 Embedding 工程落地展开,分析向量维度高低对模型性能、内存开销的影响,区分单语言与多语言向量模型;依托 MTEB 评测基准完成业务适配的 Embedding 模型筛选,帮助使用者根据业务需求挑选合适的向量化模型。接着横向对比多款主流向量数据库,包括 FAISS、Milvus、Pinecone、Elasticsearch、Weaviate、Qdrant,梳理每款工具的开源属性、性能特点以及适用业务场景,厘清不同数据库的选型边界。最后落地到实操案例,设置两套实践任务:第一例基于 Gensim 的 Word2Vec,使用《三国演义》语料完成词向量训练,实现词语相似度查询;第二例针对自有业务文档,调用 text‑embedding‑v4 接口完成文档向量化,依次完成数据预处理、向量入库构建索引、完善元数据管理,最终实现语义相似检索。整套学习路径从基础理论、模型选型、工具对比再到代码实操,打通从文本语义编码到向量检索的完整链路,适合零基础读者系统掌握 Embedding 与向量数据库的核心知识。
提示: 本内容由社区用户上传并分享。平台不对内容的真实性、合法性、知识产权归属及是否侵害第三方权利进行事前审核或保证。本内容可能包含受版权保护的图片、字体或其他第三方素材,使用前请自行确认授权范围。
- AI
- 人工智能
- RAG
- Embedding技术
- 向量数据库

- Embedding与向量数据库
想入门 RAG 语义检索,首先就要搞懂 Embedding 与向量数据库这套基础体系。本思维导图先从 Embedding 技术开始逐层讲解,先回顾传统文本特征提取方案 TF‑IDF,厘清词频 TF、逆文档频率 IDF 的计算逻辑与固有局限;再过渡到 Word Embedding 词嵌入,讲解 Skip‑Gram、CBOW 两种训练模式,借助 king‑man+woman=queen 的向量类比特性,直观理解词向量的语义表达原理。之后围绕 Embedding 工程落地展开,分析向量维度高低对模型性能、内存开销的影响,区分单语言与多语言向量模型;依托 MTEB 评测基准完成业务适配的 Embedding 模型筛选,帮助使用者根据业务需求挑选合适的向量化模型。接着横向对比多款主流向量数据库,包括 FAISS、Milvus、Pinecone、Elasticsearch、Weaviate、Qdrant,梳理每款工具的开源属性、性能特点以及适用业务场景,厘清不同数据库的选型边界。最后落地到实操案例,设置两套实践任务:第一例基于 Gensim 的 Word2Vec,使用《三国演义》语料完成词向量训练,实现词语相似度查询;第二例针对自有业务文档,调用 text‑embedding‑v4 接口完成文档向量化,依次完成数据预处理、向量入库构建索引、完善元数据管理,最终实现语义相似检索。整套学习路径从基础理论、模型选型、工具对比再到代码实操,打通从文本语义编码到向量检索的完整链路,适合零基础读者系统掌握 Embedding 与向量数据库的核心知识。
- RAG技术与应用
这是一篇关于RAG技术与应用的思维导图,主要内容包括:课程背景,RAG基础与核心原理,核心技术实践与模型选择,进阶技巧——Query改写与联网搜索。第一部分讲解 RAG 基础与核心原理,对比提示工程、RAG、微调这三种大模型应用开发模式各自的适用场景与特点;阐释 RAG 的定义,梳理它先检索、后生成的完整工作逻辑;总结 RAG 三大优势:解决知识时效性、缓解大模型幻觉问题、提升垂直领域回答专业度;拆解 RAG 核心流程为数据预处理存储、检索查找、生成回答三个阶段。第二部分是核心技术实践与模型选择,给出 Embedding 嵌入模型选型方向,分为通用文本嵌入、中文嵌入、指令驱动复杂任务模型,建议参考 MTEB 排行榜综合选型;设置实战案例,基于 DeepSeek+Faiss 搭建本地知识库,分别从技术栈、案例对象、程序逻辑结构开展实践。第三部分为进阶技巧,包含 Query 改写与联网搜索两大模块,Query 改写旨在把口语模糊查询转化为精准检索问句,可借助大模型 Prompt 自动改写输出 JSON;Query + 联网搜索用于弥补本地知识库时效性短板,处理天气、价格这类实时信息,完成查询改写、关键词构造以及搜索平台调用。整套内容从基础原理、选型实操再到进阶优化。无论想要入门 RAG 开发的学生还是 AI 应用开发从业者,都可以借助这份思维导图开展系统学习。
- FOF深度解析指南
这份思维导图是 FOF(基金中基金)深度解析指南,系统讲解 FOF 的定义特征、发展历程、投资难点、配置逻辑、产品分类、对比差异、购买细节与适配人群。FOF 即专门投资其他基金的基金,不直接买入股票债券,通过挑选多只底层基金完成资产配置,两大核心特征为分散投资、专业筛选基金,重点考察基金组合,而非单只标的。从发展历程来看,FOF 起源于海外,国内也经历制度落地、产品扩容的发展阶段,同时梳理了 FOF 和个人养老业务之间的关联。导图剖析 FOF 投资的现实难题,分别对应解决 “选基难” 与 “配置难” 两大痛点,讲解核心投资心态与收益预期,厘清 FOF 的配置价值与局限。在产品板块,划分 FOF 产品分类,梳理挑选方法论。将 FOF 与普通基金、MOM 等产品横向对比,清晰展现相互差异,FOF 的优势在于由专业机构完成基金筛选、资产分散配置,降低个人选基难度,减少单一基金踩雷风险,省去投资者频繁调仓的负担,但同时会叠加双重管理费,收益很难做到极致突出。此外还梳理购买操作细节、风险特性,明确产品的适配与局限性。无论理财新手、无暇打理资产的上班族还是想要优化基金组合的投资者都可以借助这份内容系统认识 FOF 产品。
Embedding与向量数据库
社区模板帮助中心,点此进入>>
- Embedding与向量数据库
想入门 RAG 语义检索,首先就要搞懂 Embedding 与向量数据库这套基础体系。本思维导图先从 Embedding 技术开始逐层讲解,先回顾传统文本特征提取方案 TF‑IDF,厘清词频 TF、逆文档频率 IDF 的计算逻辑与固有局限;再过渡到 Word Embedding 词嵌入,讲解 Skip‑Gram、CBOW 两种训练模式,借助 king‑man+woman=queen 的向量类比特性,直观理解词向量的语义表达原理。之后围绕 Embedding 工程落地展开,分析向量维度高低对模型性能、内存开销的影响,区分单语言与多语言向量模型;依托 MTEB 评测基准完成业务适配的 Embedding 模型筛选,帮助使用者根据业务需求挑选合适的向量化模型。接着横向对比多款主流向量数据库,包括 FAISS、Milvus、Pinecone、Elasticsearch、Weaviate、Qdrant,梳理每款工具的开源属性、性能特点以及适用业务场景,厘清不同数据库的选型边界。最后落地到实操案例,设置两套实践任务:第一例基于 Gensim 的 Word2Vec,使用《三国演义》语料完成词向量训练,实现词语相似度查询;第二例针对自有业务文档,调用 text‑embedding‑v4 接口完成文档向量化,依次完成数据预处理、向量入库构建索引、完善元数据管理,最终实现语义相似检索。整套学习路径从基础理论、模型选型、工具对比再到代码实操,打通从文本语义编码到向量检索的完整链路,适合零基础读者系统掌握 Embedding 与向量数据库的核心知识。
- RAG技术与应用
这是一篇关于RAG技术与应用的思维导图,主要内容包括:课程背景,RAG基础与核心原理,核心技术实践与模型选择,进阶技巧——Query改写与联网搜索。第一部分讲解 RAG 基础与核心原理,对比提示工程、RAG、微调这三种大模型应用开发模式各自的适用场景与特点;阐释 RAG 的定义,梳理它先检索、后生成的完整工作逻辑;总结 RAG 三大优势:解决知识时效性、缓解大模型幻觉问题、提升垂直领域回答专业度;拆解 RAG 核心流程为数据预处理存储、检索查找、生成回答三个阶段。第二部分是核心技术实践与模型选择,给出 Embedding 嵌入模型选型方向,分为通用文本嵌入、中文嵌入、指令驱动复杂任务模型,建议参考 MTEB 排行榜综合选型;设置实战案例,基于 DeepSeek+Faiss 搭建本地知识库,分别从技术栈、案例对象、程序逻辑结构开展实践。第三部分为进阶技巧,包含 Query 改写与联网搜索两大模块,Query 改写旨在把口语模糊查询转化为精准检索问句,可借助大模型 Prompt 自动改写输出 JSON;Query + 联网搜索用于弥补本地知识库时效性短板,处理天气、价格这类实时信息,完成查询改写、关键词构造以及搜索平台调用。整套内容从基础原理、选型实操再到进阶优化。无论想要入门 RAG 开发的学生还是 AI 应用开发从业者,都可以借助这份思维导图开展系统学习。
- FOF深度解析指南
这份思维导图是 FOF(基金中基金)深度解析指南,系统讲解 FOF 的定义特征、发展历程、投资难点、配置逻辑、产品分类、对比差异、购买细节与适配人群。FOF 即专门投资其他基金的基金,不直接买入股票债券,通过挑选多只底层基金完成资产配置,两大核心特征为分散投资、专业筛选基金,重点考察基金组合,而非单只标的。从发展历程来看,FOF 起源于海外,国内也经历制度落地、产品扩容的发展阶段,同时梳理了 FOF 和个人养老业务之间的关联。导图剖析 FOF 投资的现实难题,分别对应解决 “选基难” 与 “配置难” 两大痛点,讲解核心投资心态与收益预期,厘清 FOF 的配置价值与局限。在产品板块,划分 FOF 产品分类,梳理挑选方法论。将 FOF 与普通基金、MOM 等产品横向对比,清晰展现相互差异,FOF 的优势在于由专业机构完成基金筛选、资产分散配置,降低个人选基难度,减少单一基金踩雷风险,省去投资者频繁调仓的负担,但同时会叠加双重管理费,收益很难做到极致突出。此外还梳理购买操作细节、风险特性,明确产品的适配与局限性。无论理财新手、无暇打理资产的上班族还是想要优化基金组合的投资者都可以借助这份内容系统认识 FOF 产品。
- 相似推荐
- 大纲