导图社区 大数据技术体系
大数据技术体系
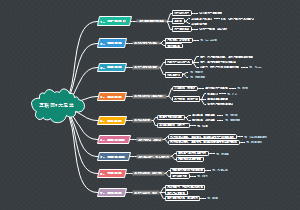
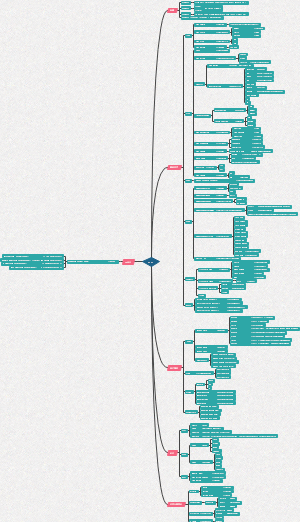
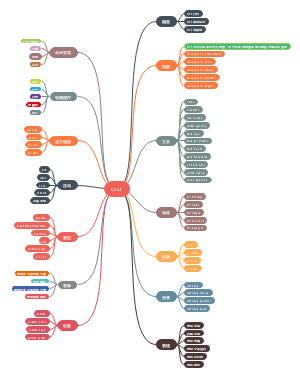
这份思维导图完整梳理大数据技术体系,整体分为数据采集、数据存储、数据处理、数据分析、数据可视化五大核心模块。数据采集包含日志、数据库、消息队列、网络爬虫四类数据源,配套 Flume、Canal、Kafka、Scrapy 等主流工具,支持批量采集与实时采集,同时通过去重、校验、断点续传做好采集质量管控。数据存储覆盖 HDFS、HBase、Redis、MongoDB 等组件,区分数据仓库、数据湖、湖仓一体方案,并附带存储选型对照表,依据业务场景选择合适存储引擎。数据处理分为批处理和流处理,包含 MapReduce、Spark、Flink、Spark Streaming 等计算引擎,介绍 Lambda、Kappa 架构,同时配有 YARN、Airflow 等资源调度与任务调度工具。数据分析涵盖 Presto、ClickHouse 等查询引擎,依托 Spark MLlib、PyTorch 等框架开展挖掘与深度学习,可实现用户行为分析、实时指标计算、预测性分析等场景,同时兼顾数据治理、结果评估与数据安全合规。数据可视化提供 Superset、Tableau、ECharts 等开源与商业工具,支持仪表盘、报表、大屏等展示形态,遵循图表选型、色彩搭配、响应优化等交互设计原则,面向业务输出分析结论。导图串联大数据全链路流程,清晰展示各组件分工与选型思路。
提示: 本内容由社区用户上传并分享。平台不对内容的真实性、合法性、知识产权归属及是否侵害第三方权利进行事前审核或保证。本内容可能包含受版权保护的图片、字体或其他第三方素材,使用前请自行确认授权范围。
- 数据存储
- 数据处理
- 数据采集
- 大数据技术
他的近期作品
查看更多>>
- 相似推荐
- 大纲