导图社区 职场学习
职场学习
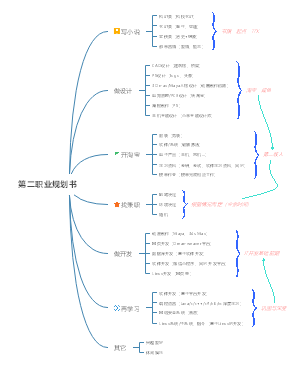
职场学习和在校学习有何区别?职场学习应该学些什么内容?如何去学?该如何制定学计划?
提示: 本内容由社区用户上传并分享。平台不对内容的真实性、合法性、知识产权归属及是否侵害第三方权利进行事前审核或保证。本内容可能包含受版权保护的图片、字体或其他第三方素材,使用前请自行确认授权范围。
- 职场学习
- 雷达图
- 登门槛效应
- ASK模型

- 可能替代RAG的技术
传统 RAG 遇挑战,三大替代技术谁主沉浮?本思维导图先剖析传统 RAG 固定流水线的本质缺陷,传统 RAG 依靠查询向量化、向量检索、拼接检索文本再送入大模型生成答案,整套流程固化,存在检索成本偏高、文本总结能力有限等短板,面对复杂企业知识库场景时容易出现信息遗漏、检索不准等问题。再深度解读超长上下文、Agentic Retrieval、LLM Wiki 三大技术及其适用边界。超长上下文技术依托大模型不断扩容的记忆容量,直接将完整文档作为输入,省去向量检索环节,适合小规模知识库,但存在 token 成本上涨、长文本中间信息遗忘等局限。Agentic Retrieval 智能体检索将检索升级为推理任务,构建思考、行动、观察的循环,依靠工具链自主规划、分步完成复杂查询,适配企业多步骤复杂检索需求。LLM Wiki 知识导航系统具备页面级语义存储、实体关系构建能力,支持知识动态更新,适合长期沉淀专业知识。最后给出技术选型指南,明确三大新技术并非全面取代 RAG,各自拥有适用场景与局限性,RAG 仍是企业级应用基石,企业可结合知识库规模、查询复杂度、成本预算灵活搭配方案。无论研究大模型应用的算法工程师、学习检索增强技术的研发人员,还是需要选型知识库方案的产品从业者,都可以借助这套分析框架理清 RAG 替代方案的技术逻辑。
- ️ 企业知识库 RAG 系统实战方案
这是一份企业知识库 RAG 系统实战方案,涵盖核心思想、基础四阶段、关键模块决策、调优验证与实践任务,并附两个案例。方案把基础 RAG 划分为解析、内容提取、检索、回答四个阶段,再拆解五大板块落地。核心模块决策是重点,依次介绍解析、内容提取、检索与重排序、父页面检索流程、增强与生成模块,覆盖 PDF 文本处理、分块策略、向量库选型、检索召回机制、提示词工程、思维链等关键技术,明确各环节选型、参数、优劣取舍。调优与验证方法依靠配置化调参与提示词构建,通过 100 个公开问题开展评测,量化系统性能,识别语义错误。实践任务设置两个案例,一是 RAG-Challenge 阅读笔记,用于解析指标与调参;二是打造中国知网 RAG 系统,对文档切分、解析、返回格式进行针对性改造。整套方案从理论阶段、模块选型、测试验证到落地案例完整串联,形成可落地的企业知识库 RAG 建设流程,清晰呈现 RAG 项目从思路到实操的全链路工程要点,覆盖技术选型、参数设置、效果评估等核心环节。无论 AI 研发工程师、企业数字化从业者,还是大模型项目学习者,都可以从中获取企业级 RAG 知识库搭建的工程化思路与实操经验。
- RAG高级技术与调优
如何提高 RAG 召回效率和精准度?本篇思维导图从知识库处理,到查询优化,到混合检索,再到精排召回,每一步都可以在不增加 LLM 负担的前提下提高召回质量。在知识库处理阶段,可通过知识库问题生成与检索向量化、对话知识沉淀、知识库质量校验、版本管理与性能对比,提前清洗、优化知识库内容,减少脏数据对检索的干扰,夯实底层数据基础。查询优化环节,采用多 Query 策略,借助大模型对原始查询进行改写、扩展,丰富检索维度,挖掘用户真实意图。检索层面使用混合检索策略,融合 BM25 关键词检索与向量检索,兼顾语义匹配与关键词命中,弥补单一检索方式的缺陷。检索完成后接入重排模型,对初步召回的候选文档做二次打分筛选,过滤无关片段,进一步提升结果精准度。导图还拓展了 GraphRAG 与 Agentic RAG 进阶方案,GraphRAG 依托知识图谱挖掘文本实体关联,适合复杂全局推理;Agentic RAG 将检索交给智能体,自主完成多轮检索规划。整套优化链路将工作量前置在检索环节,不额外增加大模型输入 token,减轻 LLM 处理压力。
职场学习
社区模板帮助中心,点此进入>>
- 可能替代RAG的技术
传统 RAG 遇挑战,三大替代技术谁主沉浮?本思维导图先剖析传统 RAG 固定流水线的本质缺陷,传统 RAG 依靠查询向量化、向量检索、拼接检索文本再送入大模型生成答案,整套流程固化,存在检索成本偏高、文本总结能力有限等短板,面对复杂企业知识库场景时容易出现信息遗漏、检索不准等问题。再深度解读超长上下文、Agentic Retrieval、LLM Wiki 三大技术及其适用边界。超长上下文技术依托大模型不断扩容的记忆容量,直接将完整文档作为输入,省去向量检索环节,适合小规模知识库,但存在 token 成本上涨、长文本中间信息遗忘等局限。Agentic Retrieval 智能体检索将检索升级为推理任务,构建思考、行动、观察的循环,依靠工具链自主规划、分步完成复杂查询,适配企业多步骤复杂检索需求。LLM Wiki 知识导航系统具备页面级语义存储、实体关系构建能力,支持知识动态更新,适合长期沉淀专业知识。最后给出技术选型指南,明确三大新技术并非全面取代 RAG,各自拥有适用场景与局限性,RAG 仍是企业级应用基石,企业可结合知识库规模、查询复杂度、成本预算灵活搭配方案。无论研究大模型应用的算法工程师、学习检索增强技术的研发人员,还是需要选型知识库方案的产品从业者,都可以借助这套分析框架理清 RAG 替代方案的技术逻辑。
- ️ 企业知识库 RAG 系统实战方案
这是一份企业知识库 RAG 系统实战方案,涵盖核心思想、基础四阶段、关键模块决策、调优验证与实践任务,并附两个案例。方案把基础 RAG 划分为解析、内容提取、检索、回答四个阶段,再拆解五大板块落地。核心模块决策是重点,依次介绍解析、内容提取、检索与重排序、父页面检索流程、增强与生成模块,覆盖 PDF 文本处理、分块策略、向量库选型、检索召回机制、提示词工程、思维链等关键技术,明确各环节选型、参数、优劣取舍。调优与验证方法依靠配置化调参与提示词构建,通过 100 个公开问题开展评测,量化系统性能,识别语义错误。实践任务设置两个案例,一是 RAG-Challenge 阅读笔记,用于解析指标与调参;二是打造中国知网 RAG 系统,对文档切分、解析、返回格式进行针对性改造。整套方案从理论阶段、模块选型、测试验证到落地案例完整串联,形成可落地的企业知识库 RAG 建设流程,清晰呈现 RAG 项目从思路到实操的全链路工程要点,覆盖技术选型、参数设置、效果评估等核心环节。无论 AI 研发工程师、企业数字化从业者,还是大模型项目学习者,都可以从中获取企业级 RAG 知识库搭建的工程化思路与实操经验。
- RAG高级技术与调优
如何提高 RAG 召回效率和精准度?本篇思维导图从知识库处理,到查询优化,到混合检索,再到精排召回,每一步都可以在不增加 LLM 负担的前提下提高召回质量。在知识库处理阶段,可通过知识库问题生成与检索向量化、对话知识沉淀、知识库质量校验、版本管理与性能对比,提前清洗、优化知识库内容,减少脏数据对检索的干扰,夯实底层数据基础。查询优化环节,采用多 Query 策略,借助大模型对原始查询进行改写、扩展,丰富检索维度,挖掘用户真实意图。检索层面使用混合检索策略,融合 BM25 关键词检索与向量检索,兼顾语义匹配与关键词命中,弥补单一检索方式的缺陷。检索完成后接入重排模型,对初步召回的候选文档做二次打分筛选,过滤无关片段,进一步提升结果精准度。导图还拓展了 GraphRAG 与 Agentic RAG 进阶方案,GraphRAG 依托知识图谱挖掘文本实体关联,适合复杂全局推理;Agentic RAG 将检索交给智能体,自主完成多轮检索规划。整套优化链路将工作量前置在检索环节,不额外增加大模型输入 token,减轻 LLM 处理压力。
- 相似推荐
- 大纲