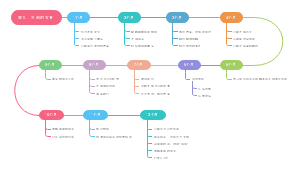
导图社区 哈萨比斯谷歌AI之脑
这是一篇关于哈萨比斯谷歌AI之脑的思维导图,这是一部关于"无限机器"缔造者的史诗传记。哈萨比斯,4岁学棋、9岁斩获国际象棋大师、17岁闯入游戏王国、38岁以AlphaGo震惊世界、48岁凭AlphaFold摘得诺奖——他的人生本身就是一场将人类智力推向极限的实验。核心命题只有一个:先解决智能,再用智能解决一切。 这不是商业口号,而是近乎宗教般的科学信仰。哈萨比斯坚信,要破解宇宙万物,必须先破解人类大脑这台"唯一已知的智能机器"。于是他跨界神经科学、游戏设计、人工智能,将强化学习与归纳推理熔铸成一把钥匙,试图打开AGI(通用人工智能)的大门。书中揭示了三条关键主线:其一,"慢科学"战胜"快行动"。与OpenAI的狂飙突进不同,DeepMind坚持基础研究优先。AlphaFold破解生物学界50年悬案,证明了长期主义的终极回报。其二,科学家与企业家的双重博弈。谷歌6.5亿美元收购DeepMind,哈萨比斯在商业机器中捍卫研发独立性,甚至策划过"马里奥计划"试图脱离谷歌控制,最终虽败犹荣——他始终在为AI安全争取底线。其三,奥本海默式的伦理困境。哈萨比斯深知自己可能是"万物的破坏者",却无法抗拒探索的诱惑。他将DeepMind比作"曼哈顿计划",在追求超级智能的同时,执意建立全球AI安全协调机制。
提示: 本内容由社区用户上传并分享。平台不对内容的真实性、合法性、知识产权归属及是否侵害第三方权利进行事前审核或保证。本内容可能包含受版权保护的图片、字体或其他第三方素材,使用前请自行确认授权范围。
这是一篇关于1999 年出版的青年办事手段全书,全书核心分为四大模块:第一模块聚焦形象塑造,提出“整理仪容不如整理表情”的核心观点,从表情管理、仪态细节、着装分寸等维度,教青年通过低成本的细节调整,快速给他人留下靠谱、干练的第一印象,比如提前5分钟赴约、3分钟内讲清一件事,用小细节建立他人的信任感。第二模块围绕人缘搭建,提出热情、尊重、诚实三大好人缘核心原则,通过记住对方名字、多用“我们”拉近距离、高频低时长见面等小技巧,帮青年快速打破社交陌生感,建立长期稳定的人际联结。第三模块针对职场场景,分别梳理了下属与上级、领导与下属的双向办事技巧,比如下属关键时刻露一手、主动揽过小过失拉近和领导的距离,领导批评下属不翻旧账、准确叫出下属名字快速提升团队凝聚力。最后一部分覆盖求职、人情往来、矛盾化解等实战场景,强调“未雨绸缪、有备无患”的办事原则,教青年在信息不全的情况下,把握办事的分寸感,避开社交雷区,在社会竞争中站稳脚跟。真的看完之后叹为观止啊。没想到上个世纪 99 年的书籍能这么夯到爆~
这是一篇关于微习惯:简单到不可能失败的自我管理法则思维导图,《微习惯》的作者斯蒂芬·盖斯曾是个彻底的懒人,他给自己定了每天做一个俯卧撑的目标,结果这个小到可笑的习惯反而彻底改变了他的人生。全书核心论点一句话:别靠意志力,靠把目标缩小到不可能失败。传统习惯养成法要求你每天跑五公里、读一小时书,靠的是动力和意志力,但意志力是消耗品,用完就没了,所以你总是三天打鱼两天晒网。微习惯的逻辑完全相反——把目标缩到荒谬的程度,比如每天只做一个俯卧撑、只读两页书、只写五十个字。因为太简单了,你根本找不到借口不做,大脑不会产生抗拒,行动阻力几乎为零。而一旦你开始做了,惯性会推着你继续做下去,一个俯卧撑往往变成十个,两页书往往变成二十页。这就是微习惯的秘密:它不是让你只做一点点,而是用零阻力启动行为,让"开始"这件事变得不可能失败。书中还强调了三个关键规则:一是把习惯拆解到小得可笑的程度,二是每次完成后给自己正向反馈,三是绝不提升目标,哪怕你觉得太简单也不要加量,因为一旦加量,大脑就会重新评估难度,抗拒感就回来了。这本书真正解决的不是"怎么坚持",而是"怎么开始"。大多数人不是输在坚持上,而是输在启动上。微习惯就是一把专门破解启动困难的钥匙,它不需要你是个自律的人,只需要你愿意做一个俯卧撑。
这是一篇关于转轨:汉武帝和他的大变革时代的思维导图,"转轨"二字,是南京大学副教授武黎嵩对汉武帝五十四年统治最精准的概括——中国历史自此终结封邦建国的古典时代,正式驶入中央集权的中古轨道,此后两千年帝制中国的核心脉络,皆奠基于此。全书十二章,打破编年体传记的传统写法,从政治、经济、社会文化、对外关系、精神信仰五个维度条分缕析。政治上,推恩令温柔拆解诸侯势力,察举制开辟"布衣卿相"通道,刺史制度以小监大、强化中央对地方的控制;经济上,盐铁专卖、均输平准、算缗告缗将国家财政能力推至极限,支撑起庞大军费,却也扼杀民间工商活力,百姓承受"盐价腾跃、告缗遍天下"之苦;文化上,罢黜百家、独尊儒术,制礼作乐、封禅泰山、设立太学,完成了思想与精神的大一统;对外,卫青霍去病决战漠北,张骞凿空西域,西汉版图全面拓展。本书最动人之处,在于调暗了帝王将相的聚光灯,将目光投向变革中的普通人。作者反复提醒:不要代入汉武帝,要代入一个汉代自耕农。每一道封狼居胥的捷报背后,是无数农夫抛下犁锄、妻离子散的身影。连年征战致"海内虚耗,户口减半",酷吏横行、冤狱牵连,民生凋敝触目惊心。
社区模板帮助中心,点此进入>>
这是一篇关于1999 年出版的青年办事手段全书,全书核心分为四大模块:第一模块聚焦形象塑造,提出“整理仪容不如整理表情”的核心观点,从表情管理、仪态细节、着装分寸等维度,教青年通过低成本的细节调整,快速给他人留下靠谱、干练的第一印象,比如提前5分钟赴约、3分钟内讲清一件事,用小细节建立他人的信任感。第二模块围绕人缘搭建,提出热情、尊重、诚实三大好人缘核心原则,通过记住对方名字、多用“我们”拉近距离、高频低时长见面等小技巧,帮青年快速打破社交陌生感,建立长期稳定的人际联结。第三模块针对职场场景,分别梳理了下属与上级、领导与下属的双向办事技巧,比如下属关键时刻露一手、主动揽过小过失拉近和领导的距离,领导批评下属不翻旧账、准确叫出下属名字快速提升团队凝聚力。最后一部分覆盖求职、人情往来、矛盾化解等实战场景,强调“未雨绸缪、有备无患”的办事原则,教青年在信息不全的情况下,把握办事的分寸感,避开社交雷区,在社会竞争中站稳脚跟。真的看完之后叹为观止啊。没想到上个世纪 99 年的书籍能这么夯到爆~
这是一篇关于微习惯:简单到不可能失败的自我管理法则思维导图,《微习惯》的作者斯蒂芬·盖斯曾是个彻底的懒人,他给自己定了每天做一个俯卧撑的目标,结果这个小到可笑的习惯反而彻底改变了他的人生。全书核心论点一句话:别靠意志力,靠把目标缩小到不可能失败。传统习惯养成法要求你每天跑五公里、读一小时书,靠的是动力和意志力,但意志力是消耗品,用完就没了,所以你总是三天打鱼两天晒网。微习惯的逻辑完全相反——把目标缩到荒谬的程度,比如每天只做一个俯卧撑、只读两页书、只写五十个字。因为太简单了,你根本找不到借口不做,大脑不会产生抗拒,行动阻力几乎为零。而一旦你开始做了,惯性会推着你继续做下去,一个俯卧撑往往变成十个,两页书往往变成二十页。这就是微习惯的秘密:它不是让你只做一点点,而是用零阻力启动行为,让"开始"这件事变得不可能失败。书中还强调了三个关键规则:一是把习惯拆解到小得可笑的程度,二是每次完成后给自己正向反馈,三是绝不提升目标,哪怕你觉得太简单也不要加量,因为一旦加量,大脑就会重新评估难度,抗拒感就回来了。这本书真正解决的不是"怎么坚持",而是"怎么开始"。大多数人不是输在坚持上,而是输在启动上。微习惯就是一把专门破解启动困难的钥匙,它不需要你是个自律的人,只需要你愿意做一个俯卧撑。
这是一篇关于转轨:汉武帝和他的大变革时代的思维导图,"转轨"二字,是南京大学副教授武黎嵩对汉武帝五十四年统治最精准的概括——中国历史自此终结封邦建国的古典时代,正式驶入中央集权的中古轨道,此后两千年帝制中国的核心脉络,皆奠基于此。全书十二章,打破编年体传记的传统写法,从政治、经济、社会文化、对外关系、精神信仰五个维度条分缕析。政治上,推恩令温柔拆解诸侯势力,察举制开辟"布衣卿相"通道,刺史制度以小监大、强化中央对地方的控制;经济上,盐铁专卖、均输平准、算缗告缗将国家财政能力推至极限,支撑起庞大军费,却也扼杀民间工商活力,百姓承受"盐价腾跃、告缗遍天下"之苦;文化上,罢黜百家、独尊儒术,制礼作乐、封禅泰山、设立太学,完成了思想与精神的大一统;对外,卫青霍去病决战漠北,张骞凿空西域,西汉版图全面拓展。本书最动人之处,在于调暗了帝王将相的聚光灯,将目光投向变革中的普通人。作者反复提醒:不要代入汉武帝,要代入一个汉代自耕农。每一道封狼居胥的捷报背后,是无数农夫抛下犁锄、妻离子散的身影。连年征战致"海内虚耗,户口减半",酷吏横行、冤狱牵连,民生凋敝触目惊心。
哈萨比斯谷歌AI之脑
1. 人物画像德米斯·哈萨比斯
1.1.1 出生与成长环境
1.1.1.1 出生细节
日期1976年7月27日
地点伦敦北部住宅区(非贵族区,普通中产家庭)
家庭住房3居室半独立屋,与两个兄弟共享房间
社区环境多元化移民社区,希腊、华人、印度、牙买加邻居
1.1.1.2 父母背景与影响
父亲尼科斯·哈萨比斯(Nikos Hassabis)
出生希腊塞浦路斯,1948年
移民1960年代移居英国
职业伦敦莱斯特广场附近经营小礼品店
性格理性、逻辑强,国际象棋爱好者(业余水平)
对Demis的影响培养逻辑思维、鼓励竞争精神
母亲李秀英(音译,Lee Siew Eng)
出生新加坡华人,1950年
移民1970年代来英留学,学习药学
职业社区药房药剂师助理
性格勤奋、注重细节、重视教育
对Demis的影响东方价值观、纪律性、长期规划
1.1.1.3 家庭文化融合
语言环境
父亲讲希腊语 + 英语
母亲讲华语(普通话+广东话)+ 英语
Demis从小接触4种语言,培养多语言思维
饮食文化
希腊菜(橄榄油、羊奶酪、烤肉)
中餐(米饭、炒菜、药膳汤)
融合饮食培养出"混合配方"思维 → 后来体现于DeepMind的跨学科方法
教育理念
父亲鼓励批判性思维,"问为什么"是家常便饭
母亲"勤奋胜过天赋",每天课后必须完成作业才能玩象棋
结果Demis 4岁起就形成"自主学习+深度专注"的习惯
1.1.1.4 经济条件与资源获取
家庭收入父亲小店年收入约£15,000(1970s英镑购买力≈今天£60,000)
可支配资源
象棋书籍/杂志每月£10预算
电脑(1987年Sinclair QL)£200,分期6个月付款
象棋比赛报名费每次£5-20,父母从不拒绝
关键资源时间 — 父母允许他每天2-3小时专注象棋(而不强迫学钢琴/游泳等)
1.2.1 天才少年时期(1980-1989)
1.2.1.1 启蒙阶段(1980-1982,4-6岁)
1980年,4岁
父亲教基本规则(车走直线、象走斜线等)
3周后在俱乐部快棋比赛中击败父亲
父亲回忆"他的眼睛能看到整个棋盘,像看一张照片"
1981年,5岁
加入伦敦少年象棋俱乐部(通常8岁+才能加入)
教练John Nunn(1955年生,国际大师,也是数学家)
第一次训练观察Nunn让Demis与其他孩子下,发现他能"记住所有棋子位置"
1982年,6岁
第一次正式比赛伦敦U7锦标赛
结果6胜0负,冠军
赛后分析Demis能复盘整局(20+步),包括对手的思考时间
1.2.1.2 快速上升期(1983-1985,7-9岁)
1983年,7岁
英国U8锦标赛冠军
成为英国最年轻的"棋联大师"(FIDE Master)候补
训练量每天3小时战术题 + 2小时经典对局分析
1984年,8岁
达到FM标准分(FIDE Master,约2300分)
正式获得FM称号(当时全球最年轻的FM之一)
媒体关注BBC Radio采访,被称为"Chess Prodigy"
1985年,9岁
首次参加成人公开赛(Hastings International Chess Congress)
与成年选手对弈5胜2负1和
关键比赛对阵Tony Miles(英国首位GM),Demis中盘失误,但Miles赛后说"这孩子10年后会成为世界冠军"
1.2.1.3 青少年大师时期(1989-1993,13-17岁)
1989年,13岁
获得国际大师(IM)称号(标准分2430+)
关键比赛英国青年锦标赛,Demis 7胜2和,无败局
训练升级每周与2-3位GM(特级大师)下私人训练局
1990-1991年,14-15岁
最高分时2500+(接近GM标准,通常2600+为GM)
参加比赛
1990年英国锦标赛第8名(与20+位GM同场)
1991年Hastings国际赛与Gary Kasparov车轮战,Demis 1.5/6(Kasparov后来说"这个孩子有Karpov的耐心")
此时意识到自己可能无法成为世界冠军(因为同龄的Judit Polgar进步更快)
1992-1993年,16-17岁
决定"转型"象棋是爱好,不是职业
原因
发现编程比下棋更有创造力
意识到自己"计算力"强但"创新力"不足
被人工智能吸引(Watson在Jeopardy!的表现启发了他)
最后一次重大比赛1993年BBC青年象棋赛,Demis夺冠后宣布"暂别职业象棋"
1.3.1 剑桥大学(1994-1997,18-21岁)
1.3.1.1 申请与入学
1993年申请
申请专业计算机科学(Computer Science Tripos)
申请学院皇后学院(Queens' College,剑桥)
面试经历
笔试算法题 + 数学证明,Demis提前30分钟完成
面试官Steve Furber(ARM架构设计者之一)
Furber问"你以后想做什么?" Demis答"设计一个能下象棋的机器,比人类强"
Furber后来说"我见过很多聪明学生,但这个孩子有'vision'"
录取 unconditional offer(无条件录取)
1.3.1.2 大学课程与成绩
第一年(1994-1995)
核心课程
算法与数据结构(Algorithm + Data Structures)95分(满分100)
离散数学(Discrete Mathematics)92分
计算机体系结构(由Steve Furber授课)98分
课外项目
用C写了个国际象棋引擎(基于Alpha-Beta剪枝)
在Sun Sparcstation上运行,能达到俱乐部水平(约1800 ELO)
第二年(1995-1996)
核心课程
人工智能I(AI I)96分
操作系统(Operating Systems)88分
编译器构造(Compiler Construction)94分
暑期实习
公司Bullfrog Productions(游戏公司)
项目参与《Syndicate》的AI模块开发
成果设计了"动态难度调整"算法(根据玩家表现调整NPC智能)
第三年(1996-1997)
核心课程
人工智能II(机器学习、神经网络)99分(年级第一)
图形学(Computer Graphics)91分
毕业论文《Neural Networks in Game AI》(85页)
毕业成绩Double First(双重一级荣誉),排名年级第2/120
1.3.1.3 大学期间的关键启发
课程启发
Steve Furber的"计算机体系结构"课
学到硬件限制如何塑造软件设计
后来应用DeepMind的TPU优化(与Google Cloud团队合作)
AI课程(由David MacKay授课,后成为剑桥物理系教授)
学到贝叶斯推理、信息论
后来应用AlphaGo的MCTS中的UCT算法(基于Upper Confidence Bound)
课外讨论
每周五晚与物理系、数学系的研究生讨论"意识的本质"
关键问题"如果神经网络能'想象',那它是否有'意识'?"
这个问题后来成为他读神经科学博士的动机之一
1.4.1 游戏行业经历(1990s-2005)
1.4.1.1 Bullfrog Productions(1990-1994)
入职经历
1990年,14岁邮寄自己设计的游戏Demo到Bullfrog
Demo内容一个用BASIC写的"人工智能模拟城市"(有简单经济模型)
Peter Molyneux(创始人)亲自回信"你16岁能来实习吗?"
1992年,16岁正式加入,是最年轻的员工
参与项目
《Theme Park》(主题公园,1994)
Demis负责的模块NPC游客的"需求模型"
技术用有限状态机(FSM)模拟游客的快乐/饥饿/疲劳
创新游客会"学习"(例如如果过山车太吓人,他们以后会避开)
成果游戏全球销量500万+,NPC AI被业界称为"突破性设计"
《Syndicate》(辛迪加,1993)
Demis的实习项目(1995年暑期)
负责敌方AI的"协作战术"(多个敌人协同攻击玩家)
技术用势场(Potential Field)算法,让敌人自动寻找掩体
经验第一次意识到"多智能体系统"的复杂性
1.4.1.2 Lionhead Studios(1996-1999)
创立背景
1996年,Peter Molyneux离开Bullfrog,创立Lionhead
邀请Demis(当时20岁,仍在剑桥读书)作为联合创始人
Demis一边读书一边工作(每周3天在 studio,2天在学校)
核心项目《Black & White》(上帝模拟游戏,2001)
AI创新
游戏核心玩家扮演"上帝",训练一个生物(Creature AI)
生物能"学习"通过观察玩家行为,调整自己的决策
技术实现
强化学习(RL)生物的行为通过奖励/惩罚调整
神经网络存储"记忆"(例如玩家喜欢它攻击村民还是保护村民)
行为树(Behavior Tree)层次化决策(先决定"目标",再决定"动作")
挑战如何让AI"可解释"?(玩家想知道"为什么我的生物这样做")
解决方案生物会用"表情"和"声音"反馈它的"想法"
开发时间线
1997年原型开发(Demis主导AI模块)
1998年Alpha版,AI行为不可预测(有时生物会"发疯")
1999年Demis决定暂停游戏开发,回去读博士("我发现游戏AI的瓶颈是'认知科学'")
2000-2001年其他团队接手,2001年发布
成果与教训
销量200万+,获Gamespy"最佳AI奖"
教训1游戏AI需要"可控的随机性"(太可预测=无聊,太随机= frustrating)
教训2玩家对AI的"情感连接"比"智能水平"更重要
这些教训后来应用到AlphaGo的"创造性走法"设计中
2. DeepMind从创业到被收购
2.1 创立背景与早期团队
2.1.1.1 Demis Hassabis 与 Shane Legg 的相遇
2005年,伦敦大学学院(UCL)
背景Hassabis刚卖掉Elixir Studios,决定回归学术
在UCL的Gordon Square咖啡馆,经朋友介绍认识Shane Legg
Legg当时是UCL的机器学习博士生(研究方向PAC学习理论)
第一次深度讨论(2005年11月)
地点Bloomsbury的一家酒吧
讨论主题" Can we build a general-purpose learning algorithm?"
关键共识
当时的AI(2005年)太碎片化(语音识别、图像识别、下棋都是独立系统)
人脑是通用学习的证明 → 应该"逆向工程"人脑
强化学习 + 深度学习 + 神经科学 = 可能的AGI路径
结果两人在餐巾纸上画出了DeepMind早期技术路线图
2.1.1.2 Mustafa Suleyman 的加入
背景
Suleyman是Hassabis在剑桥时的朋友(政治学专业,非技术背景)
2008年,Suleyman在伦敦做人权律师,同时运营一个NGO
Hassabis和Legg邀请他"我们需要一个人把AGI变成产品"
Suleyman的角色定位
CEO(商业运营)+ 地缘政治顾问
核心任务
融资(2009-2010年,他跑了50+个VC)
政府关系(后来DeepMind Health与NHS合作就是他谈的)
伦理框架(他推动了DeepMind的AI安全研究)
争议2019年离开DeepMind(传闻与Hassabis在商业化速度上有分歧)
2.1.1.3 早期团队文化
招聘标准(2010-2012年)
不招"纯粹的工程尖兵"(除非他们也懂神经科学)
偏好"T型人才"在某一领域极深,但对其他领域有好奇心
面试必问题"你最近读的非专业书是什么?"
办公室文化
每周五下午"Beer & Brain"讨论会(任何人可以提出"疯狂想法")
例子2011年,实习生提出"用神经网络玩Atari游戏" → 成为DQN项目雏形
免费晚餐每晚7点,全公司一起吃饭(讨论往往持续到深夜)
2.2 早期技术突破(2010-2014)DQN(Deep Q-Network)项目
2.2.1.1 项目起源(2011年)
灵感来源
2011年,DeepMind团队玩Atari 2600游戏机
问题"为什么AI不能像人类一样,看屏幕就学会玩游戏?"
当时的方法
传统方法为每个游戏手写规则(如《Pong》的反弹算法)
缺陷无法泛化到新游戏
DeepMind的思路端到端深度学习(输入像素 → 输出手柄指令)
技术挑战
稀疏奖励游戏中大部分操作不会立即得分(如《Pong》中可能玩几分钟才得分)
稳定性深度神经网络 + 强化学习 = 训练不稳定(早期实验经常"爆炸")
泛化在一个游戏中学到的技能,能否迁移到另一个游戏?
2.2.1.2 技术方案(2012-2014)
核心架构
输入游戏屏幕的RGB图像(210×160像素)
预处理
转为灰度图(减少计算量)
降采样到84×84
堆叠最近4帧(让网络"感知"运动)
网络结构
3层卷积神经网络(CNN)+ 2层全连接层
输出每个可能动作的Q值(动作价值函数)
训练算法Deep Q-Learning
经验回放(Experience Replay)存储过去的状态-动作-奖励,随机采样训练
目标网络(Target Network)定期同步参数,提高稳定性
关键突破(2013年)
第一次在《Breakout》游戏中达到人类水平
论文草稿2013年12月完成,2014年2月投稿《Nature》
评审意见一位评审说"这是游戏AI的ImageNet时刻"
2.2.1.3 《Nature》论文与影响(2015)
论文信息
标题"Human-level control through deep reinforcement learning"
发表2015年2月26日,《Nature》封面
作者Volodymyr Mnih(一作,乌克兰人,DeepMind研究员)+ 15位合作者
Hassabis的角色资深作者(Senior Author),提供方向和资源
实验成果
测试游戏49个Atari 2600游戏
结果
在29个游戏中,DQN达到或超越人类水平
在《Breakout》中,AI学会了"挖隧道"策略(人类玩家常用策略)
在《Pong》中,AI在100局内达到完美水平(人类需要数周练习)
泛化能力同一个网络架构,不修改代码,能在49个游戏中学习
学术影响
截至2026年,被引用25,000+次(Google Scholar数据)
启发了后续研究
A3C(Asynchronous Advantage Actor-Critic,2016)
DDPG(Deep Deterministic Policy Gradient,用于连续控制)
Rainbow DQN(整合6种DQN改进,2017)
产业应用
机器人导航(用DQN学习避障策略)
推荐系统(用强化学习优化长期用户满意度)
3. 核心技术突破
3.1 AlphaGoAI的"阿波罗时刻"
3.1.1.1 为什么选择围棋?
科学理由
象棋(1997年Deep Blue击败Kasparov)被认为是"已解决"的问题
围棋的复杂度
棋盘19×19 = 361个交叉点
可能局面数10^170(比宇宙原子数10^80还多)
国际象棋分支因子约35;围棋分支因子约250
AI领域共识(2014年前)"围棋AI达到职业水平还需要10-15年"
Hassabis的个人动机
围棋是他不会的棋类(他曾说"我下象棋,但围棋...那完全是另一个世界")
证明"跨学科方法"的威力DeepMind的AI不只是"暴力计算"(像Deep Blue),而是"学习策略"
3.1.1.2 团队组建
项目负责人David Silver(DeepMind首席科学家,象棋AI专家)
背景剑桥本科,阿尔伯塔大学博士(强化学习领域),2010年加入DeepMind
风格"理论严谨 + 工程落地"的双重能力
核心团队(2014-2016,约15人)
Aja Huang(黄士杰,台湾人,DeepMind研究员)
负责"策略网络"的训练
Background国立台湾师范大学博士,曾开发围棋程序"Erica"
Christopher Maddison(加拿大人)
负责"价值网络"的设计
Ilya Sutskever(后加入OpenAI)
短期顾问,提供深度学习建议
3.1.1.3 技术路线决策(2014年)
方案A纯监督学习(模仿人类棋谱)
优点有现成数据(KGS围棋服务器有数百万局棋谱)
缺点只能达到"模仿人类",无法超越
方案B纯强化学习(自我对弈)
优点可能发现新策略(超越人类知识)
缺点训练不稳定,可能陷入局部最优
最终方案混合方法
第1阶段监督学习(用人类棋谱训练"策略网络")
第2阶段强化学习(自我对弈,优化策略)
第3阶段蒙特卡洛树搜索(MCTS)+ 神经网络
策略网络缩小搜索范围(从361个可能走法中,选出top-5)
价值网络评估当前局面的胜率
结果搜索深度从"暴力50层"降到"智能10层"
3.2 AlphaFold蛋白质结构预测的"登月"
3.2.1.1 蛋白质折叠问题
生物学基础
蛋白质是由氨基酸序列组成的链(一级结构)
这条链会"折叠"成特定的3D结构(二级、三级、四级结构)
关键假设(Anfinsen假说,1973)
氨基酸序列 → 唯一确定的3D结构
3D结构 → 决定蛋白质的功能
实际问题已知序列的蛋白质有数亿个,但实验确定的结构只有约20万个(2024年数据)
实验方法的局限
X射线晶体学(X-ray Crystallography)
流程蛋白质结晶 → 用X射线衍射 → 解析电子密度图 → 构建3D模型
耗时几个月到几年
成本每个结构$50,000-$200,000
瓶颈很多蛋白质"不结晶"(约30%的膜蛋白无法结晶)
冷冻电镜(Cryo-EM)
2013年后技术突破(获2017年诺贝尔化学奖)
不需要结晶,但分辨率有时不够高(3-4 Å),且设备昂贵($500万+)
需求计算方法预测结构,作为实验的"预筛选"或"补充"
3.2.1.2 CASP竞赛(Critical Assessment of Structure Prediction)
1994年创立,每两年举办一次
规则
组织者选择一批"刚实验确定但未公开"的结构
参赛团队用计算方法预测这些结构
盲测评估(避免"过拟合"已知结构)
评估指标
GDT-TS(Global Distance Test - Total Score)
0-100分,>90分被认为是"接近实验精度"
2018年前,最好的计算方法GDT-TS约为60-70(远未达到实用)
3.2.1.3 DeepMind为何进入这个领域?
Hassabis的动机(2016年)
"如果AI能在围棋上战胜人类,为什么不能在科学问题上帮助人类?"
选择蛋白质折叠的原因
有明确评估标准(CASP)
有社会价值(加速药物研发)
技术可行性(深度学习在图像识别上的成功 → 可以迁移到"结构预测")
团队组建(2016-2017)
项目负责人John Jumper(美国人,芝加哥大学博士)
Background物理学家,曾在芝加哥大学开发蛋白质折叠计算方法
关键合作与EMBL-EBI(欧洲生物信息学研究所)合作,获取数据
3.3 其他重要项目(精华版)
3.3.1.1 为什么选择即时战略游戏(RTS)?
相比围棋的挑战
不完全信息战争迷雾(Fog of War)→ AI无法看到敌方全部单位
长期规划一局游戏30-60分钟,需要"宏观战略" + "微观操作"
多智能体同时控制数十个单位,每个单位需要独立决策
技术突破
多智能体强化学习(Multi-Agent RL)
每个单位有一个"注意力网络"(Attention Network)
单位之间可以"通信"(通过共享的LSTM记忆)
分层强化学习(Hierarchical RL)
高层策略决定"整体战略"(如"速攻" vs "经济发展")
低层执行控制具体单位的移动、攻击
对手建模(Opponent Modeling)
AI会"猜测"对手在做什么(基于对手的历史行为)
3.3.1.2 与人类职业选手的对决(2019年1月)
选手MaNa(波兰人,职业选手,神族玩家)
比赛结果AlphaStar 5-0 击败MaNa
争议
人类玩家批评"AI的'每分钟操作数'(APM)太高了(平均1500+,人类顶尖约300)"
DeepMind回应后续版本限制APM到人类水平,仍能达到大师级
4. AI哲学与愿景
4.1.1.1 六级AGI框架(Hassabis提出,2018年TED演讲)
Level 0窄AI(Narrow AI)
例子AlphaGo(只会下围棋)、Siri(只能做语音识别+简单对话)
特征"一个任务,一个模型"
Level 1初级通用学习
例子DQN(能玩49个Atari游戏,但每个游戏需要重新训练)
特征"多个任务,但泛化能力有限"
Level 2少样本学习(Few-Shot Learning)
目标AI看到1-10个例子就能学会新任务
当前进展GPT-4(大语言模型)在这方面有突破
Level 3零样本学习(Zero-Shot Learning)
目标AI从未见过的任务,仅通过"描述"就能执行
例子告诉AI"用这个新方法解数学题",AI不需要示范就能做
Level 4元学习(Learning to Learn)
目标AI能"学会如何快速学习新任务"
神经科学启发海马体的"快速学习"能力
Level 5AGI(人类水平)
目标在任何认知任务上达到或超越人类
Hassabis预测"可能在未来20-30年内实现"
6. 对AI行业的整体影响(完整扩展版)
6.1.1 证明深度强化学习的可行性
6.1.1.1 DQN论文的示范效应(2015-2017)
2015年《Nature》论文后
6个月内,arXiv上提交了200+篇"基于DQN的..."论文
应用领域扩展
机器人导航(用DQN学习避障策略)
推荐系统(用强化学习优化长期用户满意度)
自动驾驶(用深度RL学习变道策略)
关键转折点
2016年前强化学习被认为是"学术玩具"(只在简单环境中有效)
2016年后成为AI顶会(NeurIPS、ICML)的热门方向
数据NeurIPS 2015年RL论文约50篇;2020年约300篇
6.1.1.2 启发OpenAI等竞争对手
OpenAI的响应(2016-2018)
2016年OpenAI成立(Musk创立),目标与DeepMind类似
2017年OpenAI Five(Dota 2 AI)发布 → 明显受到AlphaGo启发
2018年OpenAI转向大语言模型(GPT系列),部分因为"DeepMind在RL领域太强"
学术界的"DeepMind效应"
2015-2020年,UCL、牛津、斯坦福等校新增"深度强化学习"课程
教科书《Reinforcement Learning: An Introduction》(Sutton & Barto)2018年再版,增加了"深度RL"章节
6.2.1 游戏AI的突破推动游戏行业创新
6.2.1.1 《AlphaGo》纪录片对游戏AI的影响
2017年纪录片《AlphaGo》
全球观众1000万+
游戏开发者开始思考"如果围棋AI能'创造',游戏NPC为什么不能?"
具体应用案例
《星际争霸II》的AI队友(2018年,暴雪与DeepMind合作)
功能AI作为"教练",分析玩家回放,提供建议
技术基于AlphaStar的训练数据,提取"人类高手的共同策略"
《赛博朋克2077》的NPC改进(2021年)
CD Projekt Red聘请DeepMind前工程师,改进NPC对话系统
技术用Transformer模型让NPC"记住"与玩家的历史对话
6.2.1.2 程序化内容生成(PCG)的进步
DeepMind的GANmE(2018)项目
目标用GAN(生成对抗网络)生成游戏关卡
应用
《马里奥》关卡生成AI生成1000+个关卡,每个都有不同难度
商业应用《No Man's Sky》(2016)的星球生成算法升级(2021年更新)
7. 争议与挑战
7.1.1.1 合作背景(2016年)
DeepMind Health的成立(2016年初)
负责人Mustafa Suleyman(联合创始人)
目标"用AI改善英国国家医疗服务体系(NHS)"
第一个项目Streams App(急性肾损伤预警系统)
与皇家自由医院(Royal Free NHS Foundation Trust)的合作
2016年5月签署协议
数据范围160万患者的医疗记录(2015-2016年)
数据用途开发Streams App(监测患者指标,预警急性肾损伤)
7.1.1.2 媒体曝光与隐私担忧(2017年5月)
《New Scientist》报道(2017年5月3日)
标题"Revealed: How Google's DeepMind will use your medical data"
揭露患者未被充分告知数据用途
反应社交媒体上#GoogleHealthData话题热议
关键问题
知情同意患者是否知道自己的数据被Google关联公司访问?
数据用途数据是否只用于Streams App,还是也会被用于其他AI项目?
数据安全Google的云服务器是否足够安全?
7.1.1.3 英国信息专员办公室(ICO)调查(2017-2018)
2017年7月ICO正式启动调查
2018年6月ICO发布调查报告
结论皇家自由医院"未能充分保护患者隐私",违反数据保护法律
具体问题
数据共享协议"过于宽泛"(允许DeepMind访问非必要数据)
患者缺乏"opt-out"机制
处罚谴责(reprimand),未罚款(因为未造成实际数据泄露)
DeepMind的回应(2018年7月)
承诺"未来会建立独立审查委员会"
行动2018年10月,将DeepMind Health转让给Google(引发进一步担忧)
8. 未来展望
8.1 技术路线图(2025-2040+)
8.1.1 短期目标(2025-2030)大语言模型与多模态AI
8.1.1.1 Gemini系列的发展规划
Gemini 1.0(2023年12月发布)
架构多模态(文本+图像+视频+代码)
性能在57个学术测试中,32个超越GPT-4
缺陷偶尔"幻觉"(生成不准确信息)
Gemini 2.0(预计2025年)
目标减少幻觉,提高推理能力
技术方向
Chain-of-Thought(思维链)优化让模型"展示推理过程"
工具使用(Tool Use)Gemini能调用计算器、搜索引擎、代码执行器
个性化根据用户历史,调整回答风格(例如对医生用专业术语,对普通用户用通俗语言)
8.1.1.2 多模态AI的突破应用
医疗诊断(预计2026-2027)
输入患者病史(文本)+ X光片(图像)+ 心电图(时序数据)
输出诊断建议 + 置信度 + 相似病例引用
挑战监管审批(FDA、CE认证)
科学文献挖掘(预计2025-2026)
项目DeepMind与Elsevier、Springer合作
功能AI自动阅读数百万篇论文,提取"知识图谱"
应用研究者输入"我想研究XX",AI推荐相关论文、关键实验方法、潜在合作者
9. 关键人物关系网
9.1.1 Eleanor Maguire(UCL教授,海马体研究先驱)
9.1.1.1 对Hassabis的学术影响
博士指导关系(2005-2010)
Maguire提供"认知神经科学"框架
Hassabis提供"机器学习"视角
合作模式"每周一杯咖啡,讨论1小时"
共同论文(2007-2015)
2007年PNAS论文"Patients with hippocampal amnesia cannot imagine new experiences"
2015年《Brain》论文"The hippocampus and imagination: a review"
影响这些论文成为"神经符号AI"(Neuro-symbolic AI)的理论基础之一
9.1.1.2 持续合作关系
2016年至今
Maguire担任DeepMind的"科学顾问"(兼职)
参与项目DeepMind的"记忆增强网络"(Memory-Augmented Neural Networks)项目
贡献确保AI模型的"快速学习"模块符合神经科学发现
10. 遗产与历史地位
10.1 科学贡献的具体衡量
10.1.1.1 高引用论文
总论文数Hassabis作为作者或合作者的论文约80篇
被引用次数
Google Scholar数据总引用150,000+次
h-index约65(2026年数据)
最具影响力的5篇论文
"Human-level control through deep reinforcement learning" (Nature, 2015)
引用25,000+次
贡献证明深度RL的可行性
"Mastering the game of Go with deep neural networks and tree search" (Nature, 2016)
引用18,000+次
贡献AlphaGo方法论
"Mastering Chess and Shogi by Self-Play with a General Reinforcement Learning Algorithm" (arXiv, 2017)
引用8,000+次
贡献AlphaGo Zero的通用性
"Improved protein structure prediction using potentials from deep learning" (Nature, 2018)
引用12,000+次
贡献AlphaFold 1
"Highly accurate protein structure prediction with AlphaFold" (Nature, 2021)
引用35,000+次(预计2026年达50,000+)
贡献AlphaFold 2,诺贝尔化学奖级成果