导图社区 流行病学第五节病例对照研究
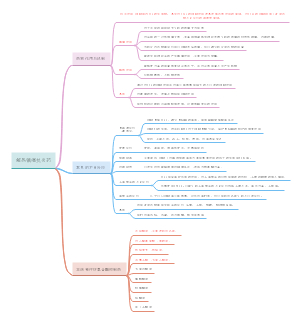
流行病学第五节病例对照研究重点知识总结,包括资料的整理与分析、常见偏倚及其控制两部分内容。
提示: 本内容由社区用户上传并分享。平台不对内容的真实性、合法性、知识产权归属及是否侵害第三方权利进行事前审核或保证。本内容可能包含受版权保护的图片、字体或其他第三方素材,使用前请自行确认授权范围。
流行病学第八节病因与因果关系推断,病因的概念,病因的研究方法和步骤,流行病学,病因推断,知识点总结。
流行病学,筛检及其评价,筛检试验的评价,评价指标,筛检效果的评价,评价指标,评价中存在的偏倚。希望对小伙伴有所帮助~
流行病学第六节流行病学实验研究思维导图,包括临床试验、现场试验和社区试验、主要偏倚及其控制、优点和局限性等等。
社区模板帮助中心,点此进入>>
小儿常见病的辩证与护理
蛋白质
均衡饮食一周计划
消化系统常见病
耳鼻喉解剖与生理
糖尿病知识总结
细胞的基本功能
体格检查:一般检查
心裕济川传承谱
解热镇痛抗炎药
病例对照研究
收集已经确诊的患有某特定疾病的一组病人作为病例组,以不患有该病但具有可比性的一组个体作为对照组,通过询问、实验室检查或复查病史,搜集研究对象既往各种可能的危险因素的暴露史,测量并比较病例组与对照组中各因素的暴露比例,经统计学检验,发现因素与疾病之间是否存在着统计学上的关联以及关联程度。 这是一种回顾性的、由结果探索病因的研究方法,是在疾病发生之后去追溯假定的病因因素的方法,是在某种程度上检验病因假说的一种观察性研究方法。
资料的整理与分析
病例对照研究资料整理表
子主题
OR,也作比数比、优势比、交叉乘积比
病例对照研究中表示疾病与暴露之间关联强度的指标为比值比
病例组的暴露比值为:  对照组的暴露比值为: 
病例对照研究的资料分析中,比较的是病例组和对照组的暴露比例,即a/a+c和b/b+d。
OR的含义与相对危险度类似,指暴露者的疾病危险性为非暴露者的多少倍。 OR>1说明疾病的危险度因暴露而增加,暴露与疾病之间为“正”关联;OR<1说明疾病的危险度因暴露而减少,暴露与疾病之间为“负”关联。
不同类型资料的分析
1.不匹配(成组)不分层资料
(1)整理四格表形式 口服避孕药(OC)与心肌梗死(MI)关系  (2)卡方检验:检验病例组与对照组两组的暴露率有无统计学显著性的差异。  已知χ20.01(1)=6.63,本例χ2=7.70>6.63,则P<0.01。结论为拒绝无效假设,即两组暴露率的差异有统计学意义。 (3)计算关联强度OR  (4)计算OR的可信区间 可信区间中不包括1.0,即可认为该0R值在0.05(95%CI)或0.01(99%CI)水平上有统计学意义。
2.不匹配(成组)分层资料
(1)整理四格表形式 按年龄分层的结果  (2)计算各层的OR OR1=(21×59)/(17×26)=2.80 OR2=(18×95)/(7×88)=2.78 (3)各层0R的同质性检验:当各层OR值接近时,说明资料是同质的(采用Woolf齐性检验)。 (4)用Mantel-Haenszel法计算调整ORMH,χ2MH和0RMH的95%CI。ORMH=2.79,总的卡方值χ2MH=11.79,0RMH的95%CI的下限为1.55,上限为5.01。 由以上分析可以看出:经分层调整后的0RMH为2.79,如不进行分层分析,则OR值为2.20,说明由于年龄的作用,减弱了口服避孕药与心肌梗死的关联,使关联强度趋向于1。在这个例子中,年龄是口服避孕药与心肌梗死关联研究中的混杂因素。
3.1:1配对资料
(1)整理四格表形式 外源性雌激素与子宫内膜癌关系  (2)卡方检验:用McNemar公式计算  (3)计算0R 本例计算得OR=29/3=9.67  (4)计算0R的95%可信区间 下限为3.67,上限为25.44,提示外源性雌激素是子宫内膜癌危险因素。
归因分值即归因危险度百分比(AR%)
指暴露人群内某种疾病的发生中,由该暴露引起的发病占全部发病的比例。
Ie为暴露组发病率,I0为非暴露组发病率。在病例对照研究中一般不能获得发病率,只能获得OR。
常见偏倚及其控制
(一)选择偏倚
1.入院率偏倚,也称Berkson偏倚
利用医院病人作为病例和对照时,由于对照是医院的某一部分病人,又由于病例只是该医院或某些医院的特定病例,因为病人对医院及医院对病人双方都有选择性,所以两组均不是随机样本。
控制:尽量随机选择研究对象或在多个医院选择。
2.现患病例-新发病例偏倚 又称奈曼偏倚。
如果调查对象选自现患病例,很多信息可能只与存活有关,而未必与该病的发病有关,从而高估了某些暴露因素的病因作用。 现患病例改变了生活习惯,从而降低了某个危险因素的水平,或被调查时夸大或缩小了病前生活习惯上的某些特征,导致某一因素与疾病的关联误差。
控制:选择新发病例,可减少偏倚程度。
3.检出症候偏倚 也称暴露偏倚
病人常因某些与致病无关的症状就医,从而提高了早期病例的检出率,致使过高地估计了暴露程度而产生的系统误差。
控制:收集的病例中同时包括早、中、晚期病人,则检出病例中此类暴露的比例会趋于正常。
(二)信息偏倚
1.回忆偏倚
2.调查偏倚
(三)混杂偏倚
当我们研究某个因素与某种疾病的关联时,由于某个既与疾病有关系,又与所研究的暴露因素有联系的外来因素的影响,掩盖或夸大了所研究的暴露因素与疾病的联系。这种现象叫混杂,造成的偏倚叫混杂偏倚。在设计时利用限制的方法和配比的方法,资料分析阶段采用分层分析或多因素分析模型处理,可适当控制混杂偏倚。
人群归因分值记为AFp,也称人群归因危险度百分比(PAR%)  Ip为总人群发病率,I0为非暴露组发病率,Pe为人群的暴露率(或以对照组的暴露代替)。AFp反映暴露对人群发病的影响,表示总人群中某种疾病的发病,由该暴露引起的发病占全部发病的比例。 AFp反映暴露对人群发病的影响,表示总人群中某种疾病的发病,由该暴露引起的发病占全部发病的比例。 例如,HBSAg携带者与肝癌的研究表明,AF=90.9%,说明表面抗原阳性者中发生肝癌数占该组人群全部肝癌数的90.9%。